JVM学习笔记
JVM
Java Virtual Machine | Java程序的运行环境(Java二进制字节码的运行环境)
优点:
一次编写,到处运行
JVM的主要目标之一 —— 跨平台能力
本质上,JVM对不同的操作系统写了不同的代码,而且据说有用多种语言的多种实现。是一种在操作系统之上的中间层——JVM为上层屏蔽了不同操作系统的差异(系统调用,内存管理,线程调度…)
自动内存管理,垃圾回收机制
else
- 数组下标越界检查:防止数据覆盖
- 多态(面向对象基石),JVM用…实现?

常见的JVM
JVM本身是一种规范,满足规范的实现都是JVM

各种实现的底层方法不同,常用JVM是HotSpot
JVM大致流程

- Java文件被编译为字节码文件
- 进入类加载器加载到内存中
- 方法区存放每个类
- 堆中存放每个对象
- 通过执行引擎完成对对象的调用 | 通过GC垃圾回收机制处理没用的对象
- 程序执行过程中需要使用 虚拟机栈、程序计数器、本地方法栈等。
java代码执行的大致流程:
Java源代码编译成.class二进制字节码文件(本身人类不可读,但可以通过反编译 成类,或者反编译成通过助记符表示的JVM指令)
通过解释器变成机器码
将机器码交给CPU执行
JVM内存结构
程序计数器

作用:
记住下一条JVM指令的执行地址
对于JVM指令而言,每条指令匹配一个执行地址
原因:
想必是因为Java中代码执行顺序不同于面向过程,是通过对象交织起来的,如此一来执行顺序的逻辑需要额外管理
like: 调用方法后返回到哪里…似乎Java中一切跳跃的代码都是在调用方法
by the way :
对比前端代码执行和Java中swing库的执行逻辑
前端:由于构建DOM树的通过每个组件绑定的方法是确定的,所以可以通过事件指定触发script标签中定义的某个具体方法。
— 也就是代码的执行顺序并非严格按照script从上到下
Swing:由于给每个组件绑定的不是方法,而是监听器对象,于是对一个事件会引发哪些方法而言,只能遍历监听器的触发方法
— 代码执行顺序还是从上到下,不过是由方法调用插入了别的代码
- CPU切换后需要保存某一线程的进度
解释器执行流程是根据程序计数器中记录的下一条指令所在位置来执行
物理实现:
利用CPU中的寄存器
特点:
线程私有
一条线程拥有一个程序计数器
不会存在内存溢出(JVM规范规定)
虚拟机栈

一个虚拟机栈对应一个线程,栈表示一段内存空间
栈中存放的元素 —— 栈帧
每个线程只能有一个活动栈帧,表示当前执行的方法
栈帧 —— 表示一次方法调用需要的内存空间
内部可能有的信息:参数、局部变量、返回地址…
注意:
垃圾回收并不涉及栈内存
由于方法调用完毕后栈内存的信息自动弹出,弹出过程就是简单的毁灭,不必动用GC
栈内存分配越大越好吗?
一个线程需要一个栈内存,内存分配越大,能同时启动的线程就越少;并且一般的栈内存足够方法调用存储信息用。
方法内的局部变量是否线程安全?
变量的线程安全 —— 一个变量对此线程是共享的,还是私有的 ——
对于某个变量的访问和操作不会引发数据不一致、不正确或者异常的问题旨在确保多个线程可以同时访问共享变量而不会导致意外的错误或不确定的结果
如果方法内局部变量没有逃离方法的作用范围 | 外界无法访问到 | 不是参数传入,也不是返回值 | 是纯粹的内部变量,它就是线程安全的
— 方法内无法定义static,只能引用static,而对static变量的引用也是线程不安全的
StackOverFlow !
栈溢出原因:
- 栈帧过多 —— 大概率来自方法递归调用
- 栈帧过大 —— 情况较少
可以显示设置栈内存大小,不然有默认值——不同操作系统设置不同,一般为1m,win会根据计算机虚拟内存进行调整

栈溢出情况举例 —— 对象转JSON导致的循环引用


隐式的递归——两方法来回调用
线程运行诊断
定位(windows下):
用tasklist定位哪个线程的内存占用过高
在资源监视器中定位哪个线程CPU是用来过高
jstack 进程id
可以查看进行下各个线程
by the way jstack是cmd命令且需要参数,于是不能直接启动jstack.cmd,而是在其目录下打开cmd,再带参数启动
本地方法栈

本地方法:
由于Java本身有限制,不能直接和底层操作系统联通,而需要通过C/CPP本地方法,与操作系统底层提供的API联通
本地方法栈:留给调用本地方法的内存空间
堆:

堆:通过new关键字,创建的对象都会使用堆内存
特点:
- 是线程共享的,堆中的对象都需要考虑线程安全问题
- 堆具有垃圾回收机制
堆内存溢出
垃圾回收机制无能为力——堆中的对象都是有用的
1 | |

更改默认堆内存大小(将堆内存设置较小易于排查潜在溢出)

堆内存诊断
工具
jps
用于查看当前系统中有哪些Java进程
jmap
用于查看堆内存的占用情况
jmap -heap 进程id
Jconsole
图形界面,多功能检测工具——可以查看之前的一切,且是实时更新的
但是有限制——需要提前知道要检测哪个进程——jps+jmap
JvisualVM
终极杀人魔火云邪神
方法:连接到对应pid的线程–堆转储Heap Dump对某一时刻的堆内存进行切片
即可查看此时堆中任何对象,对象的大小。
方法区
方法区是所有线程共享的区域,存储和类的结构相关的信息—-such as 属性(field),成员方法和构造方法,运行时常量池。
方法区在虚拟机启动时创建。
方法区在逻辑上是堆的组成部分,但不同的JVM实现的方法区的位置不同
例如:hotspot在JDK1.8之前的永久代模式方法区属于堆,但JDK1.8之后的元空间模式则不属于。


方法区内存溢出
- 1.8以前永久代模式可能会内存溢出(当内存中加载了太多类的时候)
- 1.8之后元空间和物理内存空间绑定,一般不会溢出
类加载代码:

实际开发中,并非手动加载多个类,但框架使用了许多动态字节码反编译生成类技术。
运行时常量池

引理:类反编译成可读的文本形式(本质还是二进制字节码)
通过javap反编译工具操作.class字节码文件

得知——二进制字节码文件有三个组成部分:
类的基本信息

大致内含:
最后修改时间、签名、类名、类修饰符、Java版本、继承/实现关系、字段/方法数
常量池
作用:给下面的方法提供一下常量符号

类方法用Java指令的写法是:
做什么 常量符号(参数)
其中,无论是类,类中某一方法,字符串常量…都在常量池中定义
常量池是一个k-v表
在类方法中通过k完成对常量的调用
类方法定义


方法中具体实现就是Java指令(程序计数器的目标)
- 运行时常量池——在运行时将常量池加载到内存,并将k地址引用变为真实地址
StringTable
字符串加载流程:
编译到字节码文件时,字符串都进入运行时常量池
在Java指令执行到调用某一字符串时:
查看StringTable中有无此字符串对象
如果有则引用,如果没有则将字符串创建对象并加入StringTable
(此处创建对象就是在堆中开辟空间,将对象的引用地址加入哈希表)
本质:懒加载——用到再加载
例题:
–

false
–

true
归纳:字符串如果是由字面量拼接得到,则在字节码中就是对StringTable的引用,但如果是引用变量拼接,由于变量在之后执行还可变,则只能在运行期间动态生成新字符串对象
–

通过new String() + new String()得到的结果只是对象,而非加入StringTable中
intern()方法试图将一个字符串对象加入到串池中,并返回串池中的引用对象

–

StringTable位置
Java1.6 版本中,StringTable在方法区(永久代中),但在1.8中转移到堆中
因为程序对字符串的引用很频繁,而堆的垃圾回收机制比在方法区更灵活/频繁,不容易造成内存过满。
StringTable的垃圾回收
对于未被引用的字符串对象,也会进行垃圾回收
当内存占用较大,接近运行时常量池最大内存时,会自动执行一次垃圾回收
StringTable 性能调优
由于StringTable底层按照哈希表完成,哈希表的调优取决于桶的多少
——桶过少会加大查找时间,通过多导致元素较分散,内存率使用不高,但查找会快。

设置-XX:StringTableSize=xxx
默认桶的个数是60013,桶过少导致链表过长,由于经常需要对StringTable查找有无某一元素,所以导致耗时。
性能优化业务场景
当有大量字符串需要加载到内存,而其中又有大量重复(身份证上所属籍贯…)
可以将获取到的字符串用intern()入池,返回的便是池中引用的对象
如果不入池,很可能导致字面量相同的String对象占满堆内存
入池后,仅仅不同的字符串占用StringTable中的内存
直接内存
不属于JVM堆内存,而是属于系统的可用物理内存
特点:
允许Java程序通过本地方法调用直接分配内存,而无序在Java堆上进行对象分配
使得在IO操作中性能很高
不受JVM垃圾回收机制管控,因此需要程序员来释放内存
在NIO中广泛使用
老版本读写操作:

问题在于:数据缓存了两份
利用直接内存:


垃圾回收
如何判断对象可以回收
算法:
引用计数法:
当一个对象被引用时,其计数器+1,当其计数器为0时表示可以被回收
弊端:
无法识别循环引用问题:

可达性分析算法:
首先:明确一系列根对象(肯定不能被回收的对象),其次,扫描全堆,如果被根对象引用/能够沿着根对象为起点的链引用,则拒绝回收,否则进行回收。
Question1:什么对象是根对象(GC Root)

可通过工具查看当下堆中有哪些根对象
eclipse的MemoryAnalyzer
是一个Java堆分析器,可以帮助查找内存泄漏并减少内存消耗。
方法:
通过jmap获取堆转储(Heap Dump:是Java进程在某个时刻的快照,保存了Java对象和类的信息 通常在获取Dump前进行一次GC)

MAT打开bin文件开始分析
Java中的四种引用:
强引用(之前所见所有引用)
软引用
弱引用
虚引用
终结器引用
强引用直接引用对象,其他引用类型(软引用、弱引用、虚引用)都是通过间接方式引用对象,引用本身也是普通的Java对象,持有对其他对象的引用这些引用类型的只要目的是为了影响对象的生命周期和垃圾回收行为


引用队列:
用于管理软弱虚引用对象(当其引用的对象被断开后,普通引用对象即加入引用队列)
主要作用是:当被引用的对象被垃圾回收时,通知程序或执行一系列对象被回收后执行的回调函数(钩子)。
虚引用的典型用法:
当操作直接内存时,创建了一个ByteBuffer类对象,并用虚引用对象Cleaner引用ByteBuffer。
由于当垃圾回收掉ByteBuffer时并不彻底,并没有释放掉直接内存
释放直接内存的步骤就交给虚引用对象Cleaner
虚引用在断开ByteBuffer后加入到引用队列,引用队列负责执行此虚引用的回调——根据其内存储的直接引用地址,完成内存的释放。
终结器引用:
是某个对象被回收时的回调(钩子)方法
在某个对象需要被回收前,其终结器引用会被加入到引用队列中,当引用队列通过这个终结器引用执行了引用对象的finalize()方法后,引用和引用对象双双被清理。
但据说不推荐finalize()方法

软引用:
业务场景:
当某些对象虽引用了,但由于其占用内存太大了,将其保存在内存中不如重新读取一遍要好,于是用软引用表示可以在需要被回收的时候可以垃圾回收。

如果List直接存储byte[]则为强引用
上图中,List对SoftReference为强引用,SoftReference对实际对象为软引用
软引用好处:
可以通过触发的垃圾回收机制清理出某些内存,保证程序正确执行
软引用坏处:
被清理的引用就为null了【通过引用队列标记】
软引用+引用队列示例:

给软引用绑定引用队列
在软引用关联的对象被回收时,自动将软引用加入到queue中
可以手写对queue的操作方法完成回调。
弱引用:
被弱引用关联的对象一定会被回收,即:只能活到下次垃圾回收之前
1 | |
垃圾回收算法
JVM在不同情况下使用不同的回收算法 —— 分代回收机制
标记清除算法:
一阶段:将没有引用的对象标记出来
二阶段:将垃圾对象占用的空间释放出来(标记为可覆盖)

优点:快
确定:容易产生内存碎片 —— 由于清除操作并没有对内存空间进行整理,而只是标识空白空间可以被重写,容易导致放不下更大的对象
标记整理算法:
和标记清除算法的区别在于:三阶段:整理内存

缺点:整理过程较为复杂,导致垃圾回收速度较慢
复制算法:
一阶段:标记可以被回收的垃圾
二阶段:需要一块大小相同的内存空间(to),将需要保留的对象从老空间(from)复制到新空间中,期间完成整理
三阶段:对from进行彻底的清理
四阶段:交换to和from

缺点:需要一块同等大小的内存
分代回收机制:
实现:
堆内存分为:新生代和老年代
新生代又分出伊甸园,幸存区From,幸存区To

分区的原因——不同区存放不同类型的对象——实行不同的垃圾回收机制
例:
老年代存放常用的、更有价值的对象,不经常垃圾回收
新生代存放朝生夕死的迭代很快的对象,经常垃圾回收
创建对象的过程:
首先进入伊甸园区
当伊甸园占满时,触发一次Minor GC(小垃圾回收)
将伊甸园和From区的保留的对象复制到To区
清理伊甸园和From区
交换From和To
本质上是让伊甸园做存放对象的一阶缓存,From做存放上次没清理掉的对象的二阶缓存,To是一段用于复制的中介空间
ATTENTION:
minor gc会引发 stop the world ,暂停其他用户的线程,等垃圾回收结束时,用户线程才恢复运行(由于复制过程导致对象的引用地址发生改编)
新生代 –> 老年代
情况一:
Minor GC没有清理掉的对象(进入From的)寿命+1,当寿命达到某一阈值(最大是15,因为标记此值的表头占4bit),此对象进入(晋升)老年代。
情况二:
如果Survivor空间不足以容纳存活的对象,一部分对象会被晋升到老年代。
当某一时刻:老年代的空间不足(由于老年代像是新生代的后备空间),于是调用Full GC 对全堆(新生代/老年代)进行垃圾回收。
full GC的Stop the world时间更长,因为要对全堆进行垃圾回收,但如果full GC也空不出空间来,则触发out of memory异常
据说full GC的垃圾回收机制算法

垃圾回收过程

垃圾回收器:
串行的垃圾回收器
底层:
单线程的垃圾回收器,回收垃圾时stop the world
使用场景:
堆内存较小,适合个人电脑
吞吐量优先
- 考虑因素:程序运行单位时间内,STW的时间占比最短(考虑程序整体中的垃圾回收时间)
底层:多线程
使用场景:
堆内存较大,适合多核CPU(单核的话相当于多个线程轮流清理同一个内存,效果和串行一致)
响应时间优先
- 考虑因素:尽可能使单次STW时间更短(不计程序整体执行几次GC,仅最小化单次GC时间)
底层:多线程
使用场景:
堆内存较大,适合多核CPU(same)
串行垃圾回收器
启动命令:

执行流程:

吞吐量优先的垃圾回收器(默认使用)
启动命令:(默认启动)

执行流程:

回收垃圾的线程和CPU核数相关
流程描述:
正常状态下四个CPU同时运行
开启垃圾回收
所有CPU启动垃圾回收线程,其他线程进入阻塞,共同清理同一块堆内存
- 手动控制线程数:

开启自动调整大小策略——堆中各个部分大小、晋升的阈值
由于 “响应时间最低”的垃圾回收器减少停顿时间的策略是缩小新生代从而单次垃圾回收时间更短,但是也导致minor GC更加频繁,所以并不合理,通过自动调整各代大小,追求吞吐量最高

设置目标——垃圾回收占整个程序的占比
如果要占比低,往往需要将堆调大,总体减少垃圾回收的次数

设置目标——最大暂停的毫秒数
如果要减少STW时间,往往需要将堆调小,垃圾回收扫描的空间减少

响应时间优先的垃圾回收器
开启:

并发Concurrent 标记清除MarkSweep
并发:
- 可以和用户线程并发执行
并行:
- 其他用户线程必须STW
工作流程:

初始标记——简单标标,需要STW
并发标记——在初始标记的基础上实现并发标记
重新标记——由于在并发标记阶段,其他线程可能对内存中对象有所调整,故而需要整体快速重来一遍
并发清理
感觉整个工作流程都是为了能够并发标记而前后铺垫,而之所以能够并发清理,估计是已经确定某些对象没有用了,也就线程安全了。
由于前后两个需要STW的阶段时间很短,所以叫响应时间优先的垃圾回收器
参数:

第一个是并行垃圾回收线程,设置为CPU核数,第二个是并发垃圾回收线程,此线程进行并发的垃圾回收,其他线程依旧完成用户工作
问题:
占用了一个CPU,导致对程序运行效率(吞吐量)有所影响
并发清理无法清理并发时产生的垃圾(浮动垃圾),故而需要将其保留至下一次GC
新问题是:
既然知道并发清理时会有垃圾产生,就要事先为其预留一定内存,防止内存泄漏
于是就不能和之前的垃圾回收模式一样在内存不足时进行GC,而是要提前GC
参数设置:(根据内存占比阈值)

由于并发执行中使用的是标记清除算法,不能包含整理(应该是防止影响别的线程),于是可能造成内存碎片不够用——导致降级成串行回收算法(需要先标记整理)。
如此一来时间较长
G1垃圾回收器
特点:
同时注重吞吐量和低延迟,是并行算法和并发算法的集成
适合超大的堆内存,算法会将堆划分成多个大小相等的Region,每个Region相当于小堆
整体上是标记+整理算法,两个区域之间是复制算法
启动:
JDK9之后默认使用G1,之前版本需要启动

参数设置:

流程:
三个阶段:

一阶段Young Collection 新生代垃圾回收
G1将整个堆内存划分成许多Region,分别作为伊甸园区或幸存者区或老年代

一阶段内存对象首先填充伊甸园区
当伊甸园区内存满后,通过复制算法做类似Minor GC

当幸存区内存不够,或者年龄达到阈值,晋升!

二阶段:标记
在Young GC时会进行GC Root的初始标记
当老年代占用堆空间的比例达到阈值时,进行并发标记(不会STW)
阈值由参数决定


三阶段:混合收集
对伊甸园区,幸存者区,老年代进行全面的垃圾回收

最终标记(由于并发过程其他线程产生了垃圾)
拷贝存活
E到S,进行新生代的垃圾回收
O到O,通过标记-整理算法(期间涉及区到区的复制),回收老年代的垃圾
注意:
- 并非所有老年代都参与此次的垃圾回收,而是G1会识别最该被回收的垃圾,考虑到有最长时间的限制而不能全部进行回收(复制过程较为耗时)
Minor GC 和 Full GC
对不同的垃圾回收器,两个垃圾回收模式工作于不同区域
串行GC

并行GC

CMS(并发GC)

只有当并发垃圾回收失败时,退化成串行垃圾回收,才会执行Full GC
并发失败:
并发清理阶段中:如果在并发清理期间,新生成的垃圾增加太快,快过垃圾回收的时间,将导致老年代的空间耗尽,从而促发Full GC。
由于缺少内存整理而导致的内存碎片无法放下新对象而导致的full GC
G1

也是只有当并发垃圾回收失败时,退化成串行垃圾回收,才会执行Full GC
并发失败:
并发清理阶段中:如果在并发清理期间,新生成的垃圾增加太快,快过垃圾回收的时间,将导致老年代的空间耗尽,从而促发Full GC。
由于G1的垃圾回收算法是在Region之间复制,复制过程中完成了内存整理,从而不会产生过多的内存碎片。
新生代跨代引用
由于新生代Minor GC时需要判断对象是否被引用,于是需要找出GC root,而GC Root有部分在老年代,每次young GC时都扫描老年代效率很低
于是采用 Card Table卡表技术,将老年代划分为多个区域存储对象,如果一个区域内的对象引用了新生代的对象,则标记为脏卡
在新生代中设置Remember Set 记录有哪些脏卡引用了这个新生代,于是只要遍历脏卡,扫描出响应的GC Root即可。
细说重标记
原委回顾:
- 在并发标记过程中,垃圾回收线程标记过的对象可能在之后又被用户线程调整引用(决定回收还是不回收),于是容易导致错误地将对象回收/未回收。
做法:
设置回调——对于标记线程之后的对象,如果调整其引用关系的话要触发一个回调函数(钩子)——写屏障技术
写屏障将被引用的对象加入到队列当中,并将此对象变成灰色(标记为未处理)
重标记的过程就是对队列中的对象进行重新判断处理
GC调优
技术要求:VM参数设置,相关工具
使用-XX:+PrintFlagFinal打印所有以-XX格式的参数
JVM参数
深入理解 Java 虚拟机(第二弹) - 常用 vm 参数分析_vm 引数该填什么_hello-java-maker的博客-CSDN博客
分类:
标准参数(-):所有JVM都必须实现的功能
非标准参数(-X):并非保证所有JVM都实现
非Stable参数(-XX):各个JVM实现有所不同
标准参数
通过命令行中 java -help可查看

-client
-server
以client/server模式启动JVM,C启动速度快,但运行时性能和内存管理效率不高,S是默认模式,适合生产环境,适用于服务器
-classpath
通知JVM类搜索路径?
-DpropertyName=value
定义全局属性值

-verbose
查询GC问题常用命令

另外,控制台输出GC信息还可以使用如下命令:
在JVM的启动参数中加入
-XX:+PrintGC
-XX:+PrintGCDetails
-XX:+PrintGCTimeStamps
-XX:+PrintGCApplicationStoppedTime
按照参数的顺序分别输出GC的简要信息,GC的详细信息、GC的时间信息及GC造成的应用暂停的时间.
非标准参数

-Xmn
设置新生代内存大小的最大值
-Xms
设置初始堆大小,也就是堆大小的最小值
-Xmx
设置堆的最大值
另外,官方默认的配置为**年老代大小:年轻代大小=2:1**左右,使用-XX:NewRatio可以设置年老代和年轻代之比,例如,-XX:NewRatio=4,表示年老代:年轻代=4:1-Xss
设置每个线程的栈内存
-Xprof
跟踪正在运行的程序,并将跟踪数据在标准输出输出
-Xint
设置JVM为解释模式(interpret mode)
解释模式会强制JVM逐行执行所有的字节码,运行速度较慢(没有进行JIT编译)
-Xcomp
设置JVM为编译模式(compile mode)
JVM在第一次使用时就会把所有字节码编译成本地代码(启动JIT)
-Xmixed
设置JVM为混合模式(默认)
将解释模式和编译模式进行混合使用(由JVM决定使用哪个)
非 Stable 参数
分类:
性能参数:
用于JVM的性能调优和内存分配控制
行为参数:
用于改变JVM的基础行为,比如GC的方式和算法的选择
调试参数:
用于监控、打印、输出等JVM参数,以显示详细信息


调优的领域
关于内存的垃圾回收调优
关于锁竞争的调优(并发)
关于CPU占用的调优
关于IO的调优
关于数据库调优
关于缓存和预取策略的调优
关于分布式系统的调优
确定优化的目标
高吞吐量
表示在特定时间内完成应用程序业务逻辑与垃圾回收操作的比例(即允许单次长时间垃圾回收,但只关注总体上用户线程执行的速度)
因为可能会导致较长时间的STW,所以适合不关心时延的项目
比如:科学计算
适合:ParallelGC
低延迟
关注于降低时延,尽快完成响应(即需要降低单次垃圾回收的最长停顿时间,意味着内存不会太大,吞吐量也就不会太大)
适合于互联网行业的高可用,低延迟项目
适合:CMS,G1,ZGC
优化的考虑——最快的GC是不发生GC
考虑代码的写法能否避免内存频繁地垃圾回收
数据是不是太多了
例如:resultSet = state
ment.executeQuery(“select * from user”)
将一张表的全部数据全都加载到了Java内存中,势必导致许多GC
解决方法是 limit n 避免无效数据进入内存
数据表示是否太过臃肿
例如:
也要求从数据库中获取数据避免查询没用的
对Java对象的大小初步认知
一个最小的对象:内存占16byte
基本类型int:4byte
包装类型Integer:24byte
所以加入将所有的包装类型下降到基本类型,也可以释放一部分内存
是否存在内存泄漏
例如:static Map map = …
一直向声明的静态集合中添加数据,但对之前添加的无用数据不做清理
做法:
软引用,弱引用
用第三方缓存实现对需要长期存在的数据的保存
比如:redis等,不占用JVM内存,同时拥有自己的垃圾过期算法
正式从GC考虑调优
新生代调优
新生代的特点:
所有的 new 操作的内存分配非常廉价
TLAB thread-local allocation buffer
表示伊甸园区为每个线程分配了一块内存用于创建其对象,于是不必考虑多个线程之间冲突的问题
死亡对象的回收代价是0
大部分对象是用过即死的
Minor GC的时间远远低于Full GC
原因:处理的对象区域更小,执行的操作相对简单(Full GC是全部GC,不光是老年代)
时间大概相差1-2个数量级
如何调优新生代
Question-1:新生代的内存越大越好吗?
首先内存较小会导致minor GC过于频繁
但新生代内存较大会挤掉老年代的内存——老年代比新生代更怕内存不足——老年代会触发full GC。
并且新生代内存如果过大,空出许多本不需要的区域,垃圾回收起来也反而更慢。
折中:新生代占整个堆的25%–50%
新生代的内存只要能够容纳所有的【并发量*(请求-响应)】的数据
如何调优幸存区
幸存区里是两类对象:当前活跃的对象(幸存者,但即将被回收)+ 需要晋升的对象
需要将即将被回收的对象保留在幸存区,又需要将需要晋升的对象速速晋升到老年代
原因:
如果一个马上不用的对象被粗略的晋升到老年代,会占用老年代的内存空间,导致full GC更加频繁。而只有在下次full GC时才会被清理。
如果一个常用对象一直不被晋升,其在新生代中一直minor GC却一直留下,违背了老年代提出热点对象的初衷。
所以晋升阈值需要配置得当

通过查看幸存区当下的对象(大小,年龄)来实时调整

老年代调优
以CMS为例
老年代的内存总体而言越大越好
原因:CMS中,并发清理时如果清理速度不及其他线程垃圾产生速度就会退化到full GC串行回收,于是会预留一定空间给浮动垃圾。预留空间和总空间大小相关
关于预留空间的大小设置(占整个老年代比例)

常见设置:75%–80%
回来吧我的JVM
属于JVM层面的问题
运行着的线上系统突然卡死,系统无法访问,甚至直接OOM
线上项目频繁GC,导致系统时延高
新项目上线,要设置各种JVM参数
怀疑项目出现内存泄漏,但不知道如何找出泄漏的代码
学习JVM的目的:
生产中的性能调优 –> 需要性能监控方法(命令行/可视化工具) –> 需要看得懂监控内容和指标-明白垃圾回收算法和垃圾回收器 –> 垃圾回收是基于内存的-明白内存的结构和分配 –>内存中的数据来自class文件-需要了解class文件的加载过程,解释过程
一:字节码
Q1:字节码文件时跨平台的吗?
Java虚拟机不和包括Java在内的任何语言绑定,它只和.class文件这种特定的二进制文件格式所关联
无论使用任何语言进行软件开发,只要能将源文件编译成class文件,就可以在JVM上执行
可以说统一而强大的class文件结构是JVM的基石、桥梁

Q2:.class文件里面是什么?
源代码经过编译器之后会生成字节码文件,是一种二进制的类文件(不给人读)。内容是JVM指令
Q3:如何理解Java是半解释半编译型语言?
Java将所有.java文件通过前端编译器编译成字节码文件后,具体执行是由两种方式
混合执行(Mixed-mode Execution)
解释执行(Interpreted Execution)
源代码逐行被翻译成机器码,并且翻译过程是在运行是逐行进行的 – 程序是逐行进行的
解释执行的速度相对较慢
每次运行都需要重新解释
即时编译(Just-In-Time Compilation)
JIT编译器在程序运行时将整个或部分字节码一次性编译成机器码,这种编译发生在程序执行之前(会导致启动稍慢)
一旦代码被编译成机器码,就会保存在内存中,便于之后的执行 – 不需要每次执行都进行翻译

- Java结合两方的优势,在程序启动时为了迅速执行代码使用解释器,同时在运行时会将热点代码由JIT做缓存,确保执行效率高(但最初还未记录热点代码时【预热阶段】速度较慢)
Q4:介绍一下生成class文件的编译器:
此编译器的作用就是将.java源代码编译生成.class字节码文件
常见的组件有javac,ECJ(Eclipse Compiler for Java)| hotspot VM可以切换使用二者
javac:默认使用,但每次编译都会从头开始
ECJ:ECJ编译器采取的编译方案是:增量式编译 – 把未编译的部分的源码逐行编译
因此回避javac快很多
为什么不选ECJ?
似乎因为Javac是Oracle JDK和OpenJDK提供的标准编译器,和其他部分更兼容吧
或者因为javac就在JDK中,使用也比较简单
Q5:前端编译器将.java编译成.class文件的流程:

Q6:哪些类型对应有Class对象?
类加载器将字节码文件转化成在方法区中的类
方法区中就存储着类的结构信息 - 字段信息/方法信息/构造方法/常量池…
方法区所说的这些类对象,就是代码中 Class clazz = int.class;得到的clazz
有哪些类有Class对象?
class :
外部类、内部类、匿名内部类
interface
[] 数组
enum 枚举
annotation 注解
primitive type 基本数据类型
void
Q7:什么是字节码指令(byte code)?
JVM的指令由一个字节长度的、代表都中特定操作含义的操作码 以及跟随其后的0到多个操作数 所构成
是字节码文件中的具体指令 —- 就是.class可视化后的一部分
是虚拟机能够理解和执行的操作码

Q8:关于包装类对象的缓存问题:

Integer内部类有一个IntergerCache,内部有一个数组[-128,127]表示热点数的缓存(启动时完成256个Integer的new)
创建对象时调用valueOf方法,过程中判断是否在池子中
怎么看到这个赋值过程怎么执行的?
- 查看字节码文件中的字节码指令
Others:

为什么Float和Double没有缓存?
- 因为没有热点数据 / []
Q9:如何解读字节码文件?
按照16进制打开文件并读取,但人不可读
用JClassLib插件读取,可获取到字节码指令
Q10:class文件结构是什么?
由于字节码文件是纯二进制数据,所以部分内容要么定长度,要么前置元数据标明长度
魔数

Class文件版本
2 bytes 副版本 2bytes 主版本
主版本表示JDK版本,数值45/46/…/52/53/…对应JDK1.8,1.9
存在在.class文件表示:JVM只能解释运行之前版本(向下兼容),如果版本数过高则拒绝执行

常量池计数器
2 bytes表示常量池容量计数值
计数值从1开始,1表示有0项
刻意把第0项常量空出来,是为了满足后面某些指向常量池的索引值的数据在特定情况下需要表达:不引用任何一个常量池项目的含义,此时索引值是0;
常量池
存放所有常量
访问标识(标志)
2 bytes,用于表示类/接口层面的访问信息
例如 是类还是接口、是public还是什么、是否是abstract,是否被声明为final

类索引、父类索引、接口计数器、接口索引集合

字段表集合
由于字段叫什么、字段是什么类型、都是无法固定的,所以只能将其放入常量池、再引用常量池中
所以每个字段在这里的结构都是一样的,可以直接对应到具体内容
字段计数器
对于每个字段:
标识符
访问修饰符
是否是static
是否是final
是否是volatile
是否序列化
字段数据类型
字段名称
方法表集合
属性表集合

Q11:回来吧我的垃圾回收
GC(Gabage Collection):由于内存处理是编程人员最容易出现问题的地方,不当的回收可能会导致程序不稳定甚至崩溃;Java提供的GC功能可以自动检测对象是否超过作用域从而达到自动回收内存的目的;
Java没有提供显式释放已分配内存的方法,只有System.gc()可以触发GC运行
- 当程序员创建对象时,GC就开始监控对象的地址、大小、使用情况
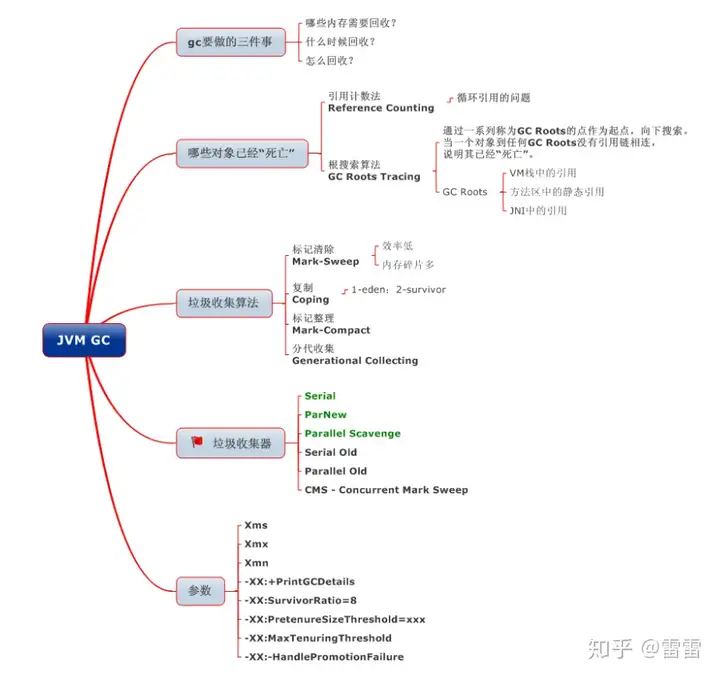
gc要做的三件事情:
明确哪些内存需要回收
判断哪些对象已经死亡
引用计数法
GC Root 标记法
什么时候回收
怎么回收
垃圾收集算法(方法论)
标记清除
标记复制
标记整理
分代收集
垃圾收集器(具体实现)
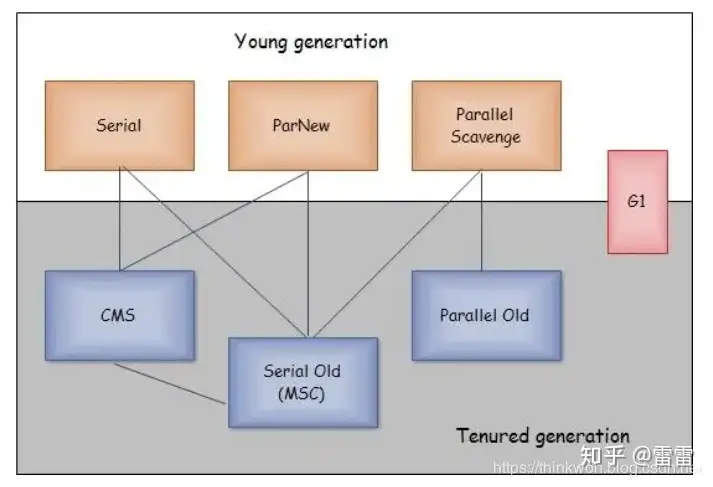
细说分代收集:
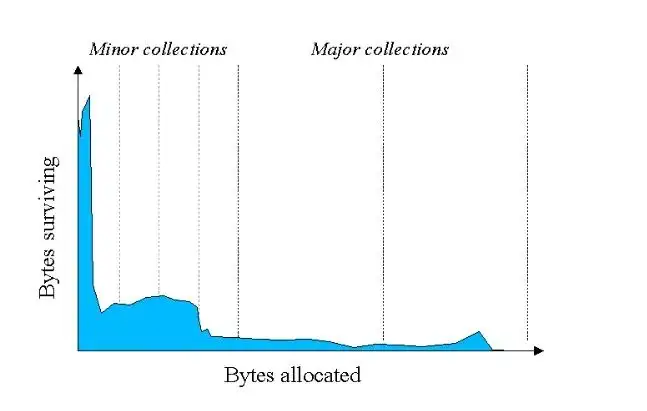
此图表示:大部分的对象都是朝生夕死,经过一次MinorGC后都会被回收;由于对象的存活周期不同,将堆分成新生代和老年代,默认比例为1:2,这样才能根据分区的特点选择合适的垃圾回收算法;新生代基于标记复制算法优化,又区分出Eden区,From Survivor区和To Survivor区,三者比例为8:1:1
很多设定都是为了避免对象过早进入老年代,尽可能减少触发Full GC。
两个Survivor以及设置年龄阈值都是为了这个条件
对象在新生代的分配与回收
创建的对象首先分配到Eden区,当Eden区将满时,触发Minor GC
大部分的对象都活不过这次Minor GC
少部分存活下来的被移动到S0(From Survivor)区,同时将存活下来的对象年龄+1;
移动完后清理Eden区(清空)
下一次minor GC时,尝试回收Eden和From区的对象,最后将幸存的对象移入To区,年龄 +1;并将From区和To区交换
标记 - 复制算法
且根据实际情况(大部分都死了)安排了一块小的复制空间,且通过算法,避免… //TODO
当对象的年龄到达设定阈值,则从S0 / S1晋升到老年代
特殊情况:
- 大对象 当某个对象分配需要大量的连续内存时,此时对象的创建不会分配在 Eden 区,会直接分配在老年代,因为如果把大对象分配在 Eden 区, Minor GC 后再移动到 S0,S1 会有很大的开销(对象比较大,复制会比较慢,也占空间),也很快会占满 S0,S1 区,所以干脆就直接移到老年代.
- 还有一种情况也会让对象晋升到老年代,即在 S0(或S1) 区相同年龄的对象大小之和大于 S0(或S1)空间一半以上时,则年龄大于等于该年龄的对象也会晋升到老年代。
回来吧我的JVM
Java概述
Java技术体系提供了完整的用于软件开发和跨平台部署的支持环境
有一个结构严谨、面向对象的语言
能够通过JVM拜托硬件平台的束缚
提供相对安全的内存管理和访问机制,避免绝大部分内存泄漏和指针越界
热点代码检查和运行时编译,保证随着运行获得更高的性能
拥有一套完整的API,各种商业机构/开源社区的第三方库
…
GraalVM
真正意义上 与物理计算机相对应的高级语言虚拟机——至于物理硬件提供不同指令集相关,而与语言无关;能够将任何语言的源代码或者源代码编译后的中间格式【GraalVM 引入了一层 Truffle framework,类似定义了用于编译功能的接口,实现这个接口的语言就可以运行在此虚拟机上】,通过解释器转化成能够被GraalVM接受的中间表示
即:设计各种解释器专门针对某种语言,将其转化成中间表示(IR)
- 和其他语言传统运行的环境相比,GraalVM能提高运行效率:编译自动优化、即时编译热点代码…
还提供了Graal 编译器,用来代替C2编译器
使用更高级 / 更复杂 / 更激进的优化算法
JVM的运行时数据区
程序计数器:当前线程所指向的字节码的行号指示器
字节码解释器的工作 就是改变计数器的值,来选取下一条要执行的指令
通过程序计数器实现程序控制流的变化,例如循环、分支、跳转、异常、陷入…
java虚拟机栈:描述线程执行方法的情况,每个栈帧包括局部变量表、操作数栈、方法出口,动态链接等.
可能出现的异常情况:
StackOverflow
OOM:当允许栈扩展但栈扩展失败时
本地方法栈:作用和虚拟机栈类似,但是为了本地方法调用服务
hotSpot虚拟机将本地方法栈和虚拟机栈合二为一
Java堆:目前版本中,所有对象实例和数组都分配在堆上
下个版本出现值类型、栈上分配技术、标量替换技术…
所有线程都尝试访问共享的堆,势必为了防止并发问题要有性能上的损失
- 解决方案之一:Java在新生代又分出多个线程私有的分配缓冲区,用于提升对象分配的效率
方法区:抽象的规范,用于存放类型信息、常量、静态变量、即时编译后代码缓存
早期:hotSpot虚拟机设计中,在内存层面方法区和老年代相邻,并且内部的元素都不易被淘汰,于是叫做永久代
此时永久代的垃圾回收和老年代绑定,无论谁满都会触发老年代垃圾回收
Java8取消永久代,方法区的实现更加零散
字符串常量池转移到Java Heap
静态变量转移到java Heap
类信息转移到元空间
元空间存在于本地内存中,垃圾回收不受JVM控制,空间不足时也不会触发GC或者OOM,而是由系统实际可用空间来控制
组成:
运行时常量池:
包括各种class文件的字面量和符号引用(静态加载进来)
以及运行时动态加载来的(String.intern());
直接内存:
虽然不受JVM管理,但收到本机总内存的限制
对象的创建:
以new关键字为例,其余还有反序列化、复制
检查指令的参数能否在常量池中定位到类的符号引用,并检查此类是否已经加载过了,若无则触发类加载
虚拟机为新生对象分配内存
问题1:对象大小确定吗:
对象设计为8字节的整数倍,其中存储对象头信息,字段信息和对齐填充,其中并无要动态扩容的信息
如何分配内存空间:
取决于垃圾回收器决定的内存布局,
标记整理的垃圾回收器可以依次紧密排列,通过指针指明占用和空闲空间的界限,标记清除的垃圾回收器只能再维护一张空闲列表
维护空闲表的成本也不低,尤其在内存中可能会拖慢响应速度
解决并发安全问题:
分配空间的操作保证不了原子性
方案:
使用乐观锁CAS机制,配合失败重试方式实现串行
TLAB:本地线程分配缓冲,只需要解决空间不足时申请空间时的并发问题【有点像leaf中的双buffer优化】;将原本很多的并发的场景合并,最后只需要解决少量并发
内存层面初始化:将原本可能被垃圾占用的空间覆盖成0值
对象初始化:修改对象头的初始化信息,例如分代的年龄信息,属于哪个类的reference信息,hashcode…
程序中,对象的初始化:执行构造函数
垃圾回收:
要解决的三件事情:
哪些内存需要回收
什么时候回收
怎么回收
垃圾回收算法:
分代收集:
经验法则:建立在两个假说之上
大多数对象朝生夕灭
命越久的对象越难以消亡
于是理应将不同生命周期的对象分类管理,采用不同的回收机制
问题:
跨代引用问题
由于原本全场一起可达性分析,假如某对象的上层消亡了自身也就消亡;但在分代回收中,可达性分析表明新生代某个对象需要回收,但无法回收其引用对象(在老年代),所以新生代的也不能回收
假说:跨代引用相对于同代引用而言很少
解决:既然少,就可以尝试牺牲额外的空间 / 时间解决
在新生代建立一个记忆集,表明哪些对象被老年代引用
标记 - 清除
缺点:内存碎片化,管理困难;连续空间不足容易触发更高级的GC
标记 - 复制
早期方法:拿出一半的复制区,两边做彼此的回收空间
优化方法:将新生代分出80%伊甸园,10%To Survivor,10%From Survivor
- 优化是因为对象的朝生夕死,一次GC能杀掉98%的新对象,并不需要等大的空间
二者的关系并非优化后决定比之前好
优化后的方法每次能存放90%空间大小的对象,其中最多只能活10%,假如GC存活的对象超过10%,则触发更高级GC
于是10%大小可能比较小,往大只有设置成50%才最保险
老年代存活比重较大,不适合M-C
标记 - 整理
矛盾:GC时是否移动对象:移动则GC时间长,不移动则分配时间长——不同目标的垃圾回收器偏好不同
偏向吞吐量的垃圾回收器选择标记 - 整理(Parallel Old)
偏向响应时间的垃圾回收器选择标记 - 清理(CMS)
垃圾回收器:
//TODO
类文件结构
无关性:
虽然所有程序最后都要编译成机器码,并且不同的操作系统,不同的硬件支持的指令集不同;
平台无关性的实现只能在操作系统之上的应用中实现:JVM
而不同语言最终编译成.class字节码文件,就是无关性的基石
无关性:既有平台无关性,也有语言无关性:不仅常规运行在JVM上的Scala,Groovy等,未来还有python,R,JS运行在graalVM上
具体结构:
Class文件是单纯的二进制流,其中不想XML,没有分割符号,目的就是最大程度的压缩空间
所以在无法使用分隔符场景下,每个字节表示的意义,顺序都定死
为了压缩空间,class文件还进行了很大程度的抽象,体现在字段表,方法表的设计上
类加载机制
类加载的过程:
加载
- 通过类的全限定名获取定义此类的二进制流
- 将字节流代表的静态存储结构转化成方法区的运行时数据结构
- 在堆内存中生成代表此类的Class对象,作为这个类在方法区的访问入口
从哪里获取class信息相当自由,衍生出许多新技术【不同的类加载器】
- 从ZIP包中读取,发展出JAR、WAR包
- 从网络中获取,发展出Applet
- 运行时计算生成,发展出JDK动态代理
- 从数据库读取
- …
验证
目的是确保Class文件的字节流信息符合规定,不会破坏程序
验证是由于Class文件并非全部来自编译器,并不能完全相信
但是验证的过程耗时很长,尤其要验证代码逻辑中有无越界,类转换异常等等需要很多时间
解决方案之一是将验证过程前移到编译器,通过一个校验码来确保中间没有被修改过
准备
将静态变量分配到内存(方法区)中
解析
装入
将常量池的符号引用转化成直接引用
初始化
执行代码逻辑,例如静态代码块
类加载器
【由一个类的全限定名,获取类的二进制字节流】
将此功能定义为接口,给不同实现功能很大的技术创新
应用场景:
- 动态类加载
- 热部署(通过自定义类加载器实现)
- OSGi:动态模块系统
- 代码加密…
每一个类加载器,都拥有一个独立的命名空间 / 两个类相等意味着在同一个命名空间下的同一个类 / 每个类加载器加载类是相互独立的
自定义类加载器:
1
2
3
4
5
6ClassLoader loader = new ClassLoader(){
@Override
public Class<?> loadClass(String name) throws ClassNotFoundException{
//具体实现方案
}
}在Java中共有两类类加载器:
- 启动类加载器(由C++编写,将基础类库里的class加载进内存)
- 其他所有加载器(java原生,都是ClassLoader子类)
三层类加载器模型:
- 启动类
- 扩展类
- 应用程序加载类
- 三层之外,用户还可以加入自定义类加载器进行扩展
但是大多数的类都是公共的,少部分类需要由特殊的加载器加载,解决此需求于是提出双亲委派模型
双亲委派:
如果一个类加载器收到类加载的请求,首先不会亲自尝试加载这个类,而是把请求委派给父类,每一层都是如此;因此所有加载请求最终都会传送到最顶层的启动类加载器,只有当父类无法完成这个加载请求时(父类的扫描范围没有这个文件),子加载器尝试自己完成加载
要求:类的等级(优先级)有划分——最重要的类(最常被加载的类)要在启动类扫描范围下
//TODO:双亲委派
字节码执行引擎:
虚拟机执行引擎与物理机执行引擎:
物理机执行引擎:建立在处理器,缓存,指令集,操作系统之上
虚拟机执行引擎:由软件提供,所使用的指令集和引擎结构体系在物理层上封装完成,更加灵活
执行分为解释执行 & 编译执行
解释执行:
解释执行过程中,方法是最基本的执行单元,每个方法对应JVM虚拟机栈中的一个栈帧,栈帧中完成方法的逻辑操作
栈帧的内容:
局部变量表:
存放方法的参数和定义的一些局部变量
这些变量基本上对整个方法都是全局可见的,所以没法在栈中分配
在将Java文件编译成Class文件时,class中就明确了局部变量表的内容;并按照变量的生命周期尝试共用一个变量来减少空间
能够体现:Class文件的设计也是为了支持执行引擎快速工作当方法被调用时,虚拟机也是通过局部变量表完成参数的传递
1
2
3
4
5
6
7关于局部变量表,有一个优化点:
垃圾回收的可达性分析就是通过局部变量表确定的GC Root
为了让没用的引用对象尽快被回收,应该考虑让没用 / 用完的变量在局部变量表中消失
消失的方案有:
- 离开作用域后被新的变量复用这个变量槽(
方法内限定变量作用域 —— 要么用{},要么用内部类,都挺少见)
- 结束后手动设置为null操作数栈:
就是操作数的栈
动态链接:
每个栈帧包含一个指向运行时常量池中该栈帧所属方法的引用
目的是为了支持动态连接
方法返回地址
方法调用:
指如何找到具体调用哪个方法
在Class文件中记录的方法调用,全都只是对常量池内的符号引用,而不是运行时期正在的方法入口,所以需要在某一时刻将符号引用转变成物理地址(直接引用)
静态解析:
在类加载的解析阶段,其实可以确定某些符号引用的具体物理地址
只要保证叫这个名字的方法只有唯一实现(不存在重载 / 重写 / 不同实现…)
符合要求的有:
- 静态方法
- 私有方法
- final修饰的方法
分派:
在一些比较类似的方法中确定调用哪个
静态分派:
指编译器能做到的选择 / 不需要虚拟机运行就能确定
引理:由于多态导致一个类对象可能对外呈现是其父类 / 接口
所以有两个概念:
- 外观类型
- 实际类型
两种类型都可以相对变化
- 外观类型可以通过强制转型,在编译期间转变
- 实际类型是谁编译期间无法确定,只能运行时确定
静态分派能够解决重载的问题,因为根据传入参数对象的外观类型可以确定一个方法;而外观类型在编译期间即可确定,所以叫做静态
特殊情况:根据传入参数能够匹配多个重载的多个方法;因为参数是多态的,任何一个父类 / 接口都符合,所以编译器只能找一个最接近的方法
动态分派:
用来实现重写,以及在重写方法中正确选择
基本思想:对于运行时才能确定真实类型的对象,方法调用时是根据其真实类型完成调用;
真实类型找不到说明继承的父类,再去父类中找
具体而言就是invokevirtual方法的执行
动态分派的实现方案:
理论OK,实现只是各种优化措施
- 优化1:虚方法表:原本遍历方法区的每个方法,找匹配的一个,匹配不了找父类方法区,优化到:维护一个表,记录真实的入口
- 优化2:类型继承关系分析
- 优化3:守护内联
单分派 / 多分派
方法的接收者和方法参数统称为方法的宗量。单分派是指基于一个宗量进行选择,多分派则指多个
Java属于
静态多分派:重载下要根据调用者和参数共同确定
动态单分派:重写时只需要根据调用者确定
语言的动态性:
动态语言:
- 类型检查的主体过程在运行期而不是编译期
- 变量无类型,而变量的值有类型 / 一个变量只有真实类型,没用外观类型——导致:编译期间能检查的很有限,许多只能在运行期间知道
编译期间有些情况可以推断外观类型实际的类型是什么,少量情况不行(random)
于是推出var关键字,用于根据右侧推断左侧类型,但是某些场景下推断不出来,于是编译时无法编译此类调用方法
c # 的dynamic类型
var其实是编译的语法糖,和真实执行无关,而dynamic类似一种动态类型——在编译时期完全不关心是什么类型,运行时才进行类型判断
感觉也很想JS,python的动态类型
Java对动态语言的执行:
方法句柄类:MethodHandler
一个MethodHandler对象,表示一个类下的一个具体方法的句柄,具体是哪个类哪个方法,编译期不清楚
如何构造一个MethodHandler?
模拟动态分派的过程:
1
2
3
4
5
6
7MethodType mt = MethodType.methodType(void.class,
String.class);
//确定方法描述符
return lookup().findVirtual(reveiver.getClass(),
"println",
mt).bindTo(receiver);
//在传入对象中动态寻找匹配的方法即:在运行时模拟invokeVirtual
基于栈的执行引擎 / 基于栈的指令集:
优点:
相比于基于寄存器的指令集需要依靠硬件,基于栈则完全依靠软件逻辑—— 是物理机 和 虚拟机 的区别【可移植性】
代码相对紧凑
缺点:
- 栈是在内存中维护的,频繁访问内存速度不如访问硬件
前端编译与优化
前端编译 == 编译的前半段 == .java -> .class文件
后端编译 == 编译的后半段 == .class -> 机器码(JIT即时编译 / AOT提前编译)
前端编译中,有一招插入式注解处理器
常规注解在运行时生效,插入式注解在编译时可修改代码,例如lombok的@Data
前端编译的优化点:语法糖
提高效率,能够让业务的思维连续,不必因为业务无关的技术问题分心
减少错误
泛型:
参数化类型——让程序员针对泛化的类型编写相同的代码,提高语言的抽象能力
Java与C#的泛型
Java:类型擦除式泛型
- 泛型只在源码中存在,编译后的字节码文件中,全部翻新被替换成裸类型,弥补方案是使用的时候强制转化
C#:具现化式泛型
- 无论在源码、编译后的中间语言、还是运行期间的CLR中,泛型表示的类型都真实存在,例如List<int>,List<String>
C#的高级用法:
由于C#中的泛型在运行期间真实存在,就可以参与代码逻辑
例如:
1
2
3
4
5//在某个泛型类中,创建泛型类的具体对象
if(item instanceof E){
}
E e = mew E();
E[] itemArray = new E[10];java中由于.class文件中早已没有泛型了,所以这个正常的逻辑无法执行,只能曲线救国——传入一个表示类型Class对象,让这个对象在运行期间表明原本泛型所表示的类型
Java类型擦除带来的问题:
运行效率较差:
Java由于擦除过程中给每个泛型类都回归成其Row Type裸类型,但基本数据类型需要转化成包装类,才能符合之前的设计
装箱拆箱的过程虽然自动,但也有点成本
其实就是调用Integer.valueof()和Integer.intValue();
其中内存中会维护Integer的池子,范围在-128到127,池子之外的Integer。每回装箱就需要new,每回拆箱就可能被回收
好处是:class文件原封不动,早期的代码照常运行
Java由于历史原因选择擦除式泛型
第一个岔路:如何兼容之前的代码
C#选择平行开发用泛型技术的新的容器,让开发者平滑迁移
Java由于当时就有新集合ArrayList和就集合Vector,再有支持泛型的集合和不支持泛型的集合显得有点冗余
于是Java选择原地变成泛型
原地变成支持泛型的容器也不意味着就要用类型擦除,只是说之前创建的ArrayList要想直接变成ArrayLsit<String>,需要保证裸类型的ArrayList是泛型的ArrayList的父类
第二个岔路:
如何实现新ArrayList能够顺利替代老ArrayList
运行时真实创建ArrayList<String>这个类,并且声明成ArrayList的子类
直接把ArrayList
还原成ArrayList
未来的解决:
值类型(c#中的int,bool…不同于Java的原生数据类型,而是继承自Object的一个类,于是就可以作为容器的原宿避免装箱拆箱)
介于int和Integer之间,和引用数据类型的区别在于,值类型的分配是在调用栈上,而不是堆里
内联类型
后端编译
即时编译器
早期 Java 程序都是通过解释器解释执行,但当虚拟机发现某个方法或代码块的运行特别频繁,就会认为这块代码是热点代码,为了提高执行效率,会把这些代码编译成本地机器码,并以各种手段进行代码优化
Java虚拟机一般都采用解释器与编译器并存的运行架构
解释器的优点:启动迅速,省去编译的时间,直接执行字节码指令
编译器的优点:随着时间推移,越来越多的代码被编译成本地代码,相较于直接执行机器码,解释执行时执行字节码相当于还要在过程中多一步编译操作
但编译热点代码也是概论问题,无法预知未来哪些代码会被执行;于是可能出现优化比较激进,此时需要解释器充当逃生门
分层编译:
未来找到解释执行和编译执行的最佳平衡点,划分了不同的编译层次
不同的编译层次适合不同场景,因为本身许多指标是矛盾的,不同层次追求不同指标【动态调整解释 + 编译的模式】
0层:不编译执行,纯解释 – 启动最快
1层:使用客户端编译器进行简单的编译,代码优化程度不高
2层:使用客户端编译器,解释器负责执行统计工作
3层:使用客户端编译器,解释器负责执行全部统计工作
4层:使用服务端编译器,耗时更长,优化更好 – 效率最高
提前编译(AOT)
即时编译的问题:
- 占用运行时资源
于是提出设想:如果能够在运行之前静态编译,那无论多复杂的优化都可以执行
Java内存模型与线程:
起因:不同的操作系统有不同的内存模型,想要实现同一个效果需要不同的代码
- 例如:分段内存模型的缓存是根据段来的,分页内存模型的缓存根据页来
JVM提出的Java内存模型JMM用来屏蔽操作系统的差异,确保Java程序在不同平台表现一致;
另外,JMM规范本身也是下层实现的接口,对上层而言也有简化操作的意义
原生操作系统并不提供类似JMM的多线程下并发访问共享变量的规则,如果开发者手写的话,可能要用到线程同步、互斥锁、型号了等等底层技术。
JMM规定了主内存和工作内存
主内存:共享变量全都放在此处【线程私有的不参与讨论】
工作内存:每个线程与内存交换数据的缓冲 / 保存了自身使用的变量的副本;
主内存对应之前所说内存的全部,工作内存对应接近CPU的高速缓存中
内存间交互的操作:
规范化变量在主内存和工作内存交互的细节,每个命令都是原子性
lock:锁定
read:读取
load:载入
use:使用
assign:赋值
store:存储
write:写入
定义了从主内存与工作内存,工作内存与执行引擎间的操作
还定义了一些使用规则【用来在原子性层面避免线程不安全场景】:
比如:不允许read与load间单独出现…不允许一个线程丢弃最佳assign的值…一个变量同一时间只能被一个线程lock…对一个变量使用lock会先清空工作内存中的缓冲,再用需要load或者assign…
操作略显繁琐,Java团队提出先行先发原则用于简单判断有无线程不安全
回来吧我的Volatile
关键字的特殊之处在于:Java团队为其开发了特有的访问规则
立即刷新回主内存
使用前强制刷新工作内存
不会重排
volatile变量特性:
全局可见:当一条现场修改了此变量的值,新值对于其他线程而言立即得知;普通变量需要再主动读取主内存后才能修改到新版本
实现方式:大概就是对volatile的操作直接在主内存中(避免了自身工作线程和主内存的不一致)、主内存改好后通知其他线程它们缓冲的volatile的信息无效了(避免下次执行引擎使用前,其他线程和主内存的数据不一致)。
通知是什么操作?
使用volatile并非一定线程安全,volatile只能保证多个线程间读操作都能读到最新版本;但可能发生脏写;
— A,B线程读到此值,都交付给寄存器 / 操作数栈进行逻辑操作了。A将数修改后,B的本地缓存虽然感知到了,但是操作数栈并没有,导致A将B写后的数据覆盖写
本质是:由于java代码层面的指令不是原子性,即使是一条Java代码可能对应多个字节码,一个字节码也可能对应多个机器码…只有强制的原子性操作才能防止竟态 —— 加锁
禁止指令重排
关键操作:在汇编的机器码中多了lock + 空操作的语句;作用是充当内存屏障
lock还是之前的lock,空操作就意味着单纯依赖lock指令的特性
原本指令重排并不是随意重排,而是确保前后依赖关系不变的情况下,将可以重排并且重排后可以避免IO、阻塞等问题的指令,以更快的方式执行嘛,lock + 空操作表示要把工作内存的数据和主内存做点交互,这就要求之前的操作全部进行完毕。
volatile同步机制用于写操作时,可能会导致在本地代码上插入许多内存屏障,会有一定开销
线程安全与锁优化
面向对象与面向过程
面向过程是站在计算机的角度抽象问题和解决问题
相对于按照对象 / 函数来组织代码,面向过程强调按照程序的执行步骤。
强调数据和过程的分离,或者是过程要避免被数据耦合
面向对象则是站在现实世界的思维方式来抽象问题,数据和行为都是对象的一部分。
- 但面向对象虽然让开发者以现实世界的思维方式解决问题,但现实和计算机世界还有差距,按照对象行为编写的代码会遇到些问题,这些问题在面向过程中很直观,比如并发问题
线程安全:
指:多个线程同时访问一个对象,不需要进行额外的同步操作,在调用方的任何操作都可以得到正确的结果。
这就要求线程安全的代码本身内部维护了线程同步等保证安全性的手段,目的就是让上层不需要再考虑线程不安全的问题
线程安全程度分级:
不可变(只读):对于一个基本数据类型,只需要声明final即可,但对于一个对象,可能需要对其所有的属性全加final,或者类似String类,外部可见的方法通过某种手段避免修改内部属性(手动维护不可变的属性)
绝对线程安全:指一个类无论运行环境如何,调用者都不需要任何额外的同步操作(很难触发异常 / 数据不一致)
常见线程安全集合只能保证相对线程安全,即:多次操作下,某一线程还是会被其他线程影响【在非原子性操作下,仍然线程不安全】
相对线程安全:保证对这个对象的但此操作是线程安全的,即:任何线程的一次get,add等操作保证顺利执行【本质过程就是将一次操作封装成原子操作】
Vector,HashTable,synchronizedMap,SynchronizedList…
线程兼容:对象本身并不安全,要求调用段正常使用同步策略
线程安全的实现方案:
互斥同步:并发多线程下,保证共享数据在同意适合制备一条线程使用
synchronized:
synchronized回关联一个锁对象,代码块加锁的方式明确指定,实例方法上的synchronized取代码所在对象实例,类方法则使用类对应的Class对象作为锁对象
在javac编译期间,对应代码前后添加两行:monitorenter & monitorexit,同时传入对象reference参数;
执行到monitorenter时,尝试获取对象锁,对象锁中标记有锁计数器,以及线程的阻塞队列
特性:
可重入
锁在执行中无法释放,线程在阻塞时无法逃离
问题:
synchronized是重量级锁,实现的代价较大
线程的阻塞与唤醒:
由于Java线程关联内核线程,每个线程阻塞操作实质都需要系统调用来阻塞内核线程
ReentrantLock:
JUC下Lock接口下的实现类 //TODO
非阻塞同步:
互斥同步带来的问题是:原本是一个悲观锁的逻辑:维护锁对象的锁技术、线程阻塞和唤醒这些悲观锁操作都有不小的开销,而乐观锁的思路就适合并发不大,无需太多同步开销的场景
思路:无论有无并发线程,先尝试修改,再说提不提交,如果在整个阶段共享数据没有被其他线程修改,则成功提交,否则就意味着这次尝试失败,可能回通过重试 进行补偿
技术难点:乐观锁下,冲突检测和设置新值必须是原子性的
类似git的先拉后推,防止多个线程都拉了老版本,都认为可以推新版本,导致的脏写操作。
原子性实现方案:依靠硬件
Java:
1
2
3
4
5
6
7
8
9
10
11
12
13
14public AtomicInteger num = new AtomicInteger(0);
num.increaseAndGet();
@IntrinsicCandidate
public final int getAndAddInt(Object o, long offset, int delta) {
int v;
do {
v = getIntVolatile(o, offset);
} while (!weakCompareAndSetInt(o, offset, v, v + delta));
return v;
//乐观锁 + 重试的充分体现
// while CAS失败,更新最新值再次重试
}