java web学习笔记
JavaWeb
入门理解:
首先用idea创建了 SpringBoot 模型,模型中针对请求编写响应方法(到底是哪个请求是用注释表明,响应什么是用返回值表示·)。
然后从一般的浏览器访问此端口(似乎是用get方法明确请求),就可以得到SpringBoot的方法返回值。
http
超文本传输协议 用于浏览器和服务器的数据传输
http基于TCP协议
- 每次请求前进行三次握手
基于请求-响应模型—–没有请求就不会有响应,一次请求对应一次响应
http是无状态协议——对事务处理没有记忆能力,每次请求-响应都是独立的
多次请求之间无法数据共享
但速度会更快
因为前后独立,服务器无法记录cookies等必要信息
解决方法是—-新技术–会话
http请求协议
请求格式:
请求行(请求数据的第一行)数据包括:
请求方式,资源路径,协议
GET /index.html HTTP/1.1
但是经常被https协议加密导致看不到
资源路径中,后面打问号跟上get方式的请求内容(长度有限)
网页访问客户端,是将自己的网址url并上要请求的参数,一起发送,于是就可以用这个“url/请求”的格式模拟访问后端服务器。
请求头:键值对们

- 请求体:针对post类型的请求,存放请求参数(长度无限)
有的被 https加密了,有的在谷歌浏览器可见,edge不可见
响应格式:
响应行:
协议,响应状态码,对状态的描述
http://1.1 200 OK
响应头:键值对们
响应体(响应正文):存放响应数据
- 响应状态码:

- 三百多表示,目标访问的服务器A的原数据已经转移了,A返回给客户端一个新服务器的位置。

常见响应头

响应头是前后端交互的关键部分,除去具体数据内容的一切需要的信息都在里面。
http协议解析
后端接收浏览器的请求,按照http协议解析出请求的内容,并按照协议将数据返回给浏览器。
用Java原生的网络编程可以做:
ServerSocket接收下字符串后,对各种情况的解析,解析后经过后端的逻辑判断,再写出一份符号http的响应数据并发回去。
有点复杂
而且解析的流程框架是不变的
于是应运而生众多web服务器/中间件——jetty,weblogic,websphere,Tomcat
Web服务器
逻辑是:
web服务器作为一个软件程序,可以对http协议进行封装,使得本地程序通过web服务器可以轻松地访问与被访问(备有IP地址和端口,并且本地文件配置到web服务器内)。这样实质上就加入了整个互联网。
于是作用分为对内对外
对内:进出封装Http
对外:通过互联网访问到本地资源的方式
web服务器的效果是监听本地计算机的某个端口,对访问来的请求进行解析,由后端程序处理解析出来的信息,生成返回的数据再由web服务器生成响应并发回去。
所以可以把web服务器理解为一个网站(实则网站还要申请域名,dns等等),可以接收请求,返回数据。不太对,web服务器是后端概念。
于是可以把某些文件配置到web服务器中,可以让找过来的请求能找到此文件(没有域名,只能按IP+端口号+文件夹,来访问)
Tomcat
文件管理

startup.bat启动tomcat,就可以通过访问此台电脑的8080端口进入tomcat
tomcat的conf/server.xml中的配置文件中可以修改默认端口号,防止冲突
http协议默认端口是80,于是如果http访问不加端口号,而tomcat默认改为80,则只需要访问到服务器。
原本据说要把 jdk的路径写入环境变量,但实际上没效果,最后的操作是:把 tomcat写进去,jdk也写进去,而且外层的环境变量和内存的 path都写了(内层的path写的是外层 +bin目录或者外层 + lib目录)
项目部署
把项目文件放到webapps文件夹下,就可以在端口后添加路径,进行访问(不过似乎还要把原来引用本地的资源也部署到文件夹里,不然访问不到的)
将一个测试的前端页面放在webapps里的Demo文件夹下
一般而言的项目部署:
将war包放入webapps中,就相当于将某个程序可被访问
war包:(web ARchive)
是一种特殊的jar包,用于打包和部署web程序(war,jar都是压缩包)。
war包里的一般组成
web前端的程序资源(HTML文件,CSS文件,JS文件,imgs图片,Videos视频)
后端程序逻辑:Servlet类和Java类
依赖库:jar包
配置文件,其他资源文件(模板文件,日志文件…)
以下是基本的war包结构:
1 | |
1 | |
起步依赖:关键的依赖,通过导入这个依赖可以顺带导入这个依赖依赖的依赖
黑马这缺心眼的老小子,经典的白雪
Spring Boot框架已经整合好了Tomcat包,启动Spring Boot实际已经启动Tomcat,而且Spring Boot也会自动整合配置部署。
请求响应
cs和bs
cs:Client/Server。将业务逻辑和数据部分配置在客户端,这样做的优点是用户体验较好,因为访问本地比较快,缺点是开发,维护比较麻烦。
客户端负责用户界面,输入输出,通信,基本功能,离线功能
服务器负责业务逻辑,数据存储,客户端的通信(连接)
bs:Browser/Server。客户端只需要浏览器,应用程序的逻辑和数据都存储在服务器,优点是方便维护,缺点是访问较慢,体验一般。
用户通过浏览器向服务器发送请求,并通过浏览器显示接收的web页面和资源。
客户端(浏览器)负责显示页面,输入输出
服务器负责一切。
区别:
1 | |
servlet是一个接口,里面定义了Java类被浏览器访问到(tomcat识别到)的规则。tomcat就是一个servlet容器。
似乎·在tomcat接收到浏览器的http请求后只是初级的解释了一手,具体里面包括http方法(get,post),URL路径,请求头,请求参数等等会封装成一个可访问的对象requestServlet,经过servlet内的逻辑来对此对象的属性调用,servlet调度下层控制层进行操作并返回数据,再由servlet返回给tomcat,tomcat封装成http格式返回给浏览器。
当初说的真对了
所以说在servlet中有得到请求信息的方法:HttpServletRequest获取请求信息;HttpServletResponse生成并发送HTTP请求。(tomcat已经透明了,因为必须有tomcat接收)
Servlet
工作原理:
Servlet接口定义了Servlet(内含逻辑的实现类)和Servlet容器之间的契约。即:容器将实现类加载到内存,并产生其实例对象供调用方法。
对于浏览器请求动态资源,需要先经过代码的逻辑才能决定返回什么响应,这些逻辑就是服务器的核心功能。但是这些代码的执行没有main方法,是依赖于tomcat容器的调用。而想要被tomcat识别并调用,需要符合一定规则(Java中符合规则就是实现接口)。较底层的规则——Servlet
在一个应用程序中,每种Servlet类型只能有一个实例
用户请求到容器,确定到容器中的某个对象。容器会封装好两个对象——ServletRequest和ServletResponse。
ServletRequest像是解析http的,后者像是打包成http的
对每个应用程序,Servlet容器会创建一个ServletContext上下文对象(程序的运行环境),
对每个Servlet对象,会有一个ServletConfig对象封装其配置。
接口必要的三方法:
1 | |
init():首次请求此Servlet时执行的初始化操作
service():每次请求Servlet时,调用此方法
destory():要销毁Servlet时调用。
还有非必要两方法:
1 | |
getServletConfig():返回这个对象的ServletConfig配置信息对象
据说是由容器传给init方法的
getServletInfo():返回Servlet对象的一段描述
ServletRequest接口
1 | |
ServletResponse接口
1 | |
常用:
- getWriter(),返回一个Java.io.PrintWriter对象:可以向客户端发送文本
但默认编码是ISO-8859-1,会产生中文乱码
- getOutputStream(),返回二进制流,此方法用来发送二进制数据
在发送任何HTML之前,应该先调用setContentType()方法,设置响应的内容类型,并将“text/html”作为一个参数传入,这是在告诉浏览器响应的内容类型为HTML,需要以HTML的方法解释响应内容而不是普通的文本,或者也可以加上“charset=UTF-8”改变响应的编码方式以防止发生中文乱码现象。
ServletConfig接口
既然是关于Servlet对象的配置信息,必然在初始化时完成——是由容器向init方法传入的。
关于初始化信息:

tomcat容器扫描文件后进行初始化时,通过配置文件or直接完成属性的依赖注入。这些属性就是初始化参数。
ServletContext对象
上下文:代表容器的运行环境——每个应用程序拥有一个ServletContext对象(在分布式下将一个应用程序部署到多个容器时,每个JVM上的应用都有一个刻画环境的上下文对象)
ServletContext提供了一种在Servlet之间共享信息的机制,它可以用来获取Web应用程序的全局信息、配置参数和执行环境。
有一点点像反射
通过request的getServletContext方法即可获取此对象。
方法小记:
- getMimeType():获取某文件的Mime类型
MIME类型是“多用途Internet邮件扩展”(Multipurpose Internet Mail Extensions)的缩写。它是一种标准,用于标识在Internet上传输的文档的性质和格式。
MIME类型由两部分组成:主类型和子类型
主要包括:
文本类型:text/plain、text/html、text/css、application/json等。
图像类型:image/jpeg、image/png、image/gif等。
音频类型:audio/mpeg、audio/wav、audio/ogg等。
视频类型:video/mp4、video/webm、video/quicktime等。
应用程序类型:application/pdf、application/zip、application/msword等。
其实就是从文件后缀到类型的映射关系,这些映射关系记录在tomcat的配置文件config–>web.xml下
getContextPath():获取请求路径的工程名?

毕竟是关于整个上下文的,就是关于整个应用程序环境的,得不到request的具体路径也合理
servlet可以通过配置实现加入容器,也可以通过注解形式
通过配置文件大致要做的事情:
将servlet类对应一个name

将servlet的name对应一个url

以上本质就是将访问8080的请求能根据子路径对应到某个类。
可选:
初始化参数
配置过滤器
等等
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36<?xml version="1.0" encoding="UTF-8"?>
<web-app xmlns="http://xmlns.jcp.org/xml/ns/javaee"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://xmlns.jcp.org/xml/ns/javaee http://xmlns.jcp.org/xml/ns/javaee/web-app_4_0.xsd"
version="4.0">
<!-- 配置Servlet -->
<servlet>
<servlet-name>MyServlet</servlet-name>
<servlet-class>com.example.MyServlet</servlet-class>
<!-- 设置初始化参数 -->
<init-param>
<param-name>myParam</param-name>
<param-value>Hello, this is an initialization parameter.</param-value>
</init-param>
</servlet>
<!-- 配置Servlet映射 -->
<servlet-mapping>
<servlet-name>MyServlet</servlet-name>
<url-pattern>/myservlet</url-pattern>
</servlet-mapping>
<!-- 配置过滤器 -->
<filter>
<filter-name>MyFilter</filter-name>
<filter-class>com.example.MyFilter</filter-class>
</filter>
<!-- 配置过滤器映射 -->
<filter-mapping>
<filter-name>MyFilter</filter-name>
<url-pattern>/*</url-pattern>
</filter-mapping>
</web-app>
很类似Spring中配置bean.xml,通过配置文件决定加载哪些类到内存,继而由容器/框架完成加载。
全是接口,难以实现
于是给出一些实现类(抽象类)
GenericServlet
思想有一点点像AdaptedMouse,将接口的全部接口方法都只做基本的实现,程序员不需要implements接口来实现所有类,而是extands这个GS把需要的类重写
此方法有点抽象——表面上实现类ServletContext,但底层关于上下文的方法都靠init时传入的对象…不懂不懂
<u>将init( )方法中的ServletConfig参数赋给了一个内部的ServletConfig引用从而来保存ServletConfig对象</u>,不需要程序员自己去维护ServletConfig了。HttpServlet
1
2public abstract class HttpServlet extends GenericServlet implements Serializable
//表明HttpServlet是由GenericServlet扩展而来的

源码分析:
关于service()方法的分析
由于GS是抽象类,GS中的service方法就是抽象方法,定义了基本参数ServletRequest和ServletResponse,需要子类写完。
HttpServlet的做法是:
一方面要实现用ServletRequest和ServletResponse的service方法,一方面有更高级的httpServletRequest和httpServletResponse可以用。
于是在属于实现的方法中通过强转将参数升级,接着传入用高级参数的方法。
1
2
3
4
5之所以能够这样强制的转换,
是因为在调用Servlet的Service方法时,
Servlet容器总会
传入一个HttpServletRequest对象和HttpServletResponse对象,
预备使用HTTP。因此,转换类型当然不会出错了。
流程:
service方法是一个分流器,通过解析request参数中的请求方式,分流到其他方法中。
doGet,doPost,doHead,doPut,doTrace,doOptions和doDelete
于是对应继承的类而言——只需要重写常用的几个方法,doGet,doPost等即可。
HttpServletRequest接口
封装了解析http请求的各种方法
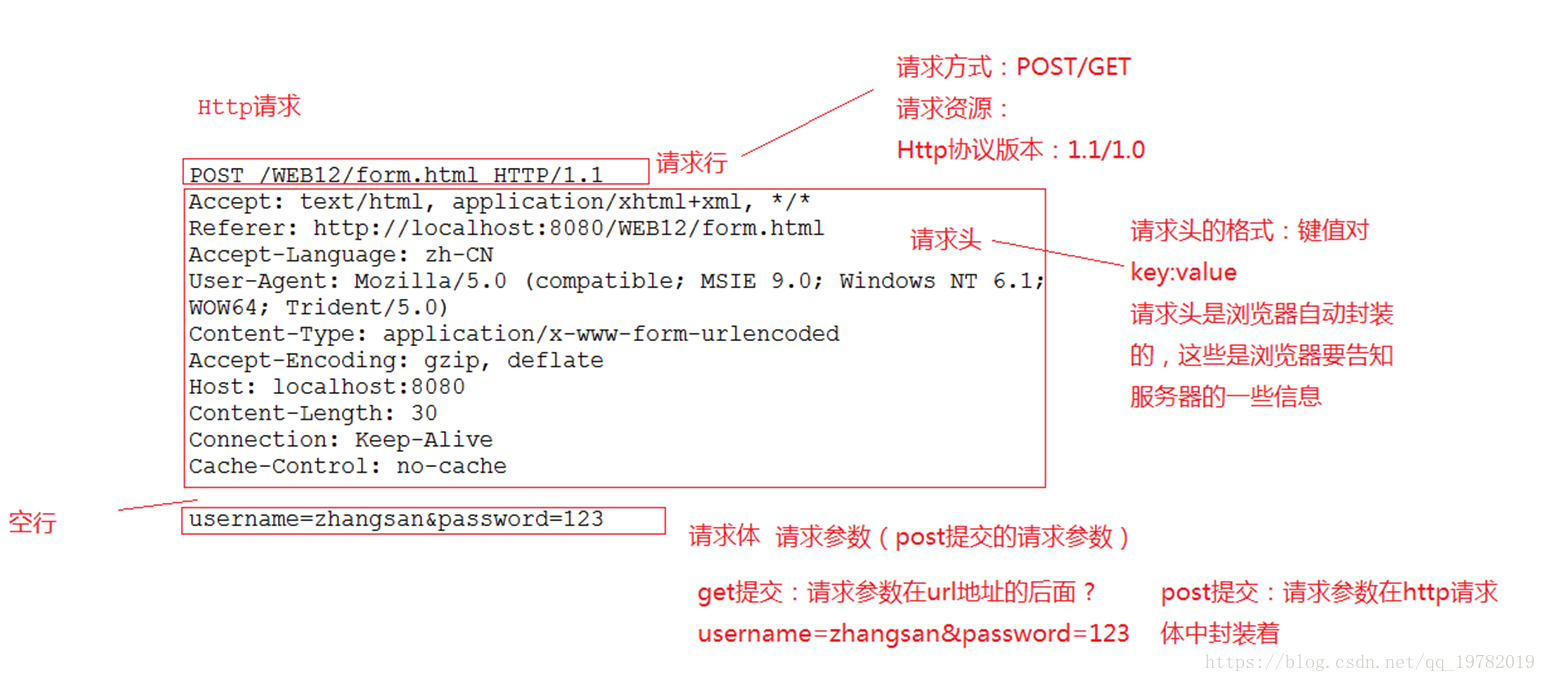
通过request获得请求行
假设查询字符串为:username=zhangsan&password=123
获得客户端的请求方式:String getMethod()
获得请求的资源:
String getRequestURI()
StringBuffer getRequestURL()
String getContextPath() —web应用的名称
String getQueryString() —- get提交url地址后的参数字符串
通过request获得请求头
long getDateHeader(String name)
String getHeader(String name)
Enumeration getHeaderNames()
Enumeration getHeaders(String name)
int getIntHeader(String name)
referer头的作用:执行该此访问的的来源,做防盗链
通过request获得请求体
请求体中的内容是通过post提交的请求参数,格式是:
username=zhangsan&password=123&hobby=football&hobby=basketball
key value
username [zhangsan]
password [123]
hobby [football,basketball]
以上面参数为例,通过一下方法获得请求参数:
String getParameter(String name)
String[] getParameterValues(String name)
Enumeration getParameterNames()
Map<String,String[]> getParameterMap()
乱码:
前面说到从servletRequest获取的PrintWriter编码方式为ISO-8859-1,这里的一系列涉及编码的盲猜也统一是ISO的。
传输流程——
前端初步向后端传输:转化成UTF-8,到达servlet,试图用ISO解码。
解决方式——
要么前端传来的变成ISO,要么后端解析时用UTF-8

HttpServletRsponse接口
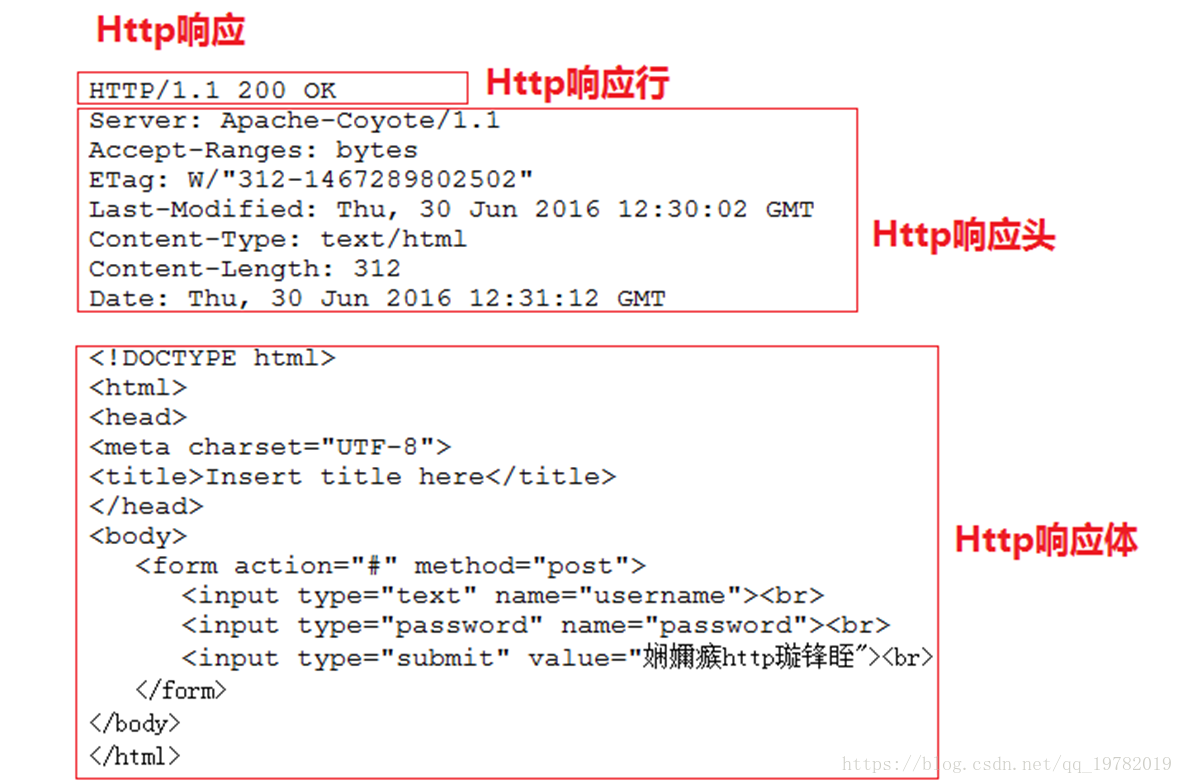
方法:
void addCookie(Cookie var1);
//给这个响应添加一个cookie
void addHeader(String var1, String var2);
//给这个请求添加一个响应头
void sendRedirect(String var1) throws IOException;
//发送一条响应码,讲浏览器跳转到指定的位置
void setStatus(int var1);
//设置响应行的状态码
PrintWriter getWriter():
获得字符流,通过字符流的write(String s)方法可以将字符串设置到response缓冲区中,随后Tomcat会将response缓冲区中的内容组装成Http响应返回给浏览器端。
据说是会封装到http的响应头中
1
2
3
4
5
6
7
8
9
10
11
12
13@Override
protected void doGet(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {
response.setContentType("text/html"); // 设置响应内容类型为HTML
PrintWriter writer = response.getWriter();
writer.println("<html>");
writer.println("<body>");
writer.println("<h1>Hello, this is the response body!</h1>");
writer.println("</body>");
writer.println("</html>");
writer.close(); // 关闭PrintWriter流
}ServletOutputStream getOutputStream():
获得字节流,通过该字节流的write(byte[] bytes)可以向response缓冲区中写入字节,再由Tomcat服务器将字节内容组成Http响应返回给浏览器。
注意:虽然response对象的getOutSream()和getWriter()方法都可以发送响应消息体,但是他们之间相互排斥,不可以同时使用,否则会发生异常。
乱码:
警惕servlet和前端浏览器使用的默认编码方式都不是UTF-8,那么要改UTF-8就要改两头
servlet:
浏览器通过设置请求头来改
不过有前辈封装了两个方法:
response.setContentType(“text/html;charset=UTF-8”)
对于乱码,更改request是为了在后端处理中正确显示(IDE显示…)所以是更改方法直接传来的Request;而更改response是为了正确传下去(浏览器等显示),所以对Filter而言是更改filterChain参数中的response。


SUM UP

返回的信息——通过response对象写入response缓冲区的内容
早期:写的内容进入返回体,直接呈现在前端页面
beanUtils工具jar包
来自apache
基础功能:request内含的参数通过getParamsMapping得到map对象,通过工具可以直接转化成一个实体类对象的属性。

- 叫做beanutils就需要user类符合bean类的规范
框架——SpringBoot
回来吧我的SpringBoot,我最骄傲的信仰
javaBean
bean是符合一些规范的java类,这些规范是为了让框架顺利调控类的实现、调用、相互关系等等
规范:
类必须被public修饰
必须提供空参的构造器
成员变量必须使用private
提供公共的setter和getter方法
或许不满足某一条程序可以跑通,但就怕设计人员把是否符合规范本身设计成报错点。
postman
给后端程序员测试后端程序用的。作用是模仿前端程序给后端接口发送请求,因为从浏览器的url请求只能执行get请求。
postman有 cs的程序和 bs的 web界面,但为啥 web的不能发给 localhost?
参数
简单参数
get
原生方法:Java程序中声明controllerMapping方法来让浏览器可以直接访问到,然后在此方法中接收请求对象,得到对象的参数后经过逻辑程序,return些东西。
- 这里的传参就是在url后紧跟。(get方法)

后端:
1 | |
SpringBoot中的方法:(自动接收参数+自动类型转化)
后端语法:
1
2
3
4
5@RequestMapping("/simpleParam")
public String simpleParam(String name,Integer age){
System.out.println("成功");
return nameMap.get(name)+" : "+ ageMap.get(age);
}方法参数名只要和请求名字相同,SpringBoot会自动接收给此参数并转化到声明的类型。
此时的形参,就是实参
post
后端的代码一致,前端发送的参数在请求体中
也可以不一致——后端用PostMapping专门只接收Post请求

解决形参名和请求中参数名字不一致——@requestParam()
1 | |
作用是将请求的参数映射到后端的形参中,也可以用于必要性声明(required=true)
复杂参数
前端依旧挨个传,后端封装成对象接收(前端传的每个参数必须是基本数据类型)
如果User里面一个引用对象没有属性,那传不传也没有意义

数组参数
get方法的写法:

post方法写法类似
后端
用数组接收:对于这种一个key多个value的,springboot会自动识别为数组
1
2
3
4
5
6
7
8
9@RequestMapping("/arrayParam")
public String arrayParam(String[] name){
System.out.println("成功");
StringBuffer sb=new StringBuffer();
for (int i = 0; i < name.length; i++) {
sb.append(nameMap.get(name[i]));
}
return sb.toString();
}用集合接收:集合接收的话必须强制映射,因为springboot只会对基本数据类型进行自动转型(由String转到声明的类型,但引用数据类型好像不行)
1
2
3
4
5
6
7
8
9@RequestMapping("/listParam")
public String listParam(@RequestParam List<String> name){
System.out.println("成功");
StringBuffer sb=new StringBuffer();
for (int i = 0; i < name.size(); i++) {
sb.append(nameMap.get(name.get(i)));
}
return sb.toString();
}始终注意参数名和请求里的参数名要相同,SpringBoot才会接收准
时间参数
由于前端传递的时间类型多种多样(一个String里表示时间),于是在后端要准确的接收需要预先声明时间的表示类型

1 | |
注意:pattern的参数是大写小写,哪个字母竟然还有影响
JSON参数
前端请求:

注意:
- 只能发post,还得选中raw和后面的文本类型是JSON
- JSON格式是:总体用{},内层也用{},所有key加双引号””,value是String也要””.
后端:
1 | |
注意:
- 参数要加注解
- 前端传递的键,是接收对象的属性
路径参数
参数直接写到路径里/要把路径的最后部分作为参数
前端:

后端:
1 | |
记录:
动态参数
往往用{}包裹,内部是可识别其他属性的标识符
在js的字符串中
js定义字符串可以用’hello’,”hello”,`hello`
其中第三个用反引号表示时,内部识别${},然后里面的内容既是一个普通的js属性
在mybatis的配置中

在此
or

1 | |
可以切出路径来
or

1 | |
获取多个路径
响应
通过给方法或类添加注解@ReponseBody表示方法的返回值将直接作为http请求的返回值。
通常在Controller类文件上添加@RestController注解:@RestController=@Control+@ResponseBody
返回值:
如果返回实体对象/集合(引用数据类型),前端按照JSON接收
1 | |
后端:
1 | |
前端:
1 | |
后端的返回值多种多样,不适合前端解析,于是后端返回值规定统一形式——
1 | |
需要注意的是:需要返回的属性必须要设置get方法,据说JSON序列化Result对象时,就是根据get方法得到各种属性,而非直接访问属性(get更规范吧)。
事实证明给get方法随便改个名字也无法正常序列号——规范很标准
三层架构:
之前的操作在一个页面里面完成数据接收,逻辑处理,数据库交互,再次处理数据,响应返回。很明显写到一起犯了大忌——难debug,难维护,难读
Controller 控制层:负责接收前端发送的请求,对请求进行处理,并响应数据
Service 业务逻辑层:处理具体的业务逻辑
Dao 数据访问层(data access object):负责数据访问操作,包括数据的增删改查。

注意:
对于Dao层而言,可能接收来自各种方式的数据:XML,JSON,txt……所以可以定义接口来规定接收与返回的规范,在各种实现中完成不同的访问逻辑。
Service层也类似,用接口写死的是层与层之间的规范,这是分层的必须条件。

分层解耦:
内聚:一个Java文件/类/模块中操作的代码都只和事务的一部分相关,不相关的不在一个类中——高内聚
耦合:表示各个层/模块之间的依赖,关联程度
表示这部分代码受外界变化的影响程度,外界一变就报错——高耦合
由于controller层创建了service层的对象,表示如果service层如果改变一个实现类,或者类名改变,controller中的代码也要变——下层对上层不完全透明。
开发原则:高内聚,低耦合
解决方案:
既然创建指定下层对象会耦合,那就不主动挑下层的哪一个对象,而是让下层自己送上来一个实现类。这通过下层向一个容器中存储许多实现类,上层需要的话从容器中拿出对应的。
技术:
控制反转(IOC):指对象创建的控制权由程序自身转移到外部(容器)/(上层转移到下层)。
依赖注入(DI):容器为运行的程序提供需要的依赖资源。
bean对象:在容器中的对象们的统称。
技术落地:
将需要放入容器的类加注解:@Component标识bean对象
- 对要被用到的加@component,对不用的不加,感觉有点鸡肋
将在上层模块中声明的下层(容器中的)对象加注解:@Autowired
IOC详解:
对于要放入IOC容器的类,声明的注解@Component是基础注解
以下有三个特定情况的注解:
@Controller:定义在控制器类中
@Service: 定义在业务类上
@Repository: 定义在数据访问类上
@Component: 用于其他类(如工具类)
组件扫描:
加载过程中,IOC容器对相应的包进行扫描,对其中有IOC注解的类进行IOC,标注为bean对象,加入到IOC容器中,但这个扫描的包应该扫描多少呢?
- 默认情况在主函数上声明了@SpringBootApplication,其中包括了@ComponentScan(),设置的默认范围是本包和其子包,也可以显示的再声明一次,不过覆盖的声明既要包括目的包,也要包括本包。
DI详解:
- @Autowired 自动装配表示声明此注解的属性会自动在容器中寻找唯一适配的bean对象。
不自动:不同@Autowired,用@Resource(name=”beanName”)指定要注入的bean对象。
IOC容器中对象不唯一,由于@Autowired是根据类的类型在IOC中寻找,那如果类的对象(接口实现类)不唯一,需要设置偏好
@Primary 在此bean类上设置优先
@Qualifier (“beanName”),表明在选择时选取这个bean对象
> beanName默认是类名小写,声明bean的时候可以添加name属性

1 | |

1 | |
数据库连接池
数据库连接池是一个容器,负责分配,管理数据库连接(Connection)
工作原理:
在系统初始化的时候,将数据库连接作为对象,存储在内存中。
设想是:当用户需要访问数据库时,避免次次建立新连接——取而代之是从连接池中取出一个空闲的连接对象。使用完毕后,安安静静放回去就好。
所以问题的难点是:连接的建立,断开,使用,由连接池自身如何管理。
在此之上有更丰富的设计:连接池可以控制连接的上下限数,每个连接的最大使用次数,最大空闲时间等。
优势:
- 资源重用
- 提高系统响应速度
- 避免数据库连接遗漏——一个客户端始终占线导致一个连接无法使用,而mybatis可以检测无效连接时长
标准接口:DataSource
常见产品: Druid德鲁伊 ,Hikari追光者
连接池产品就是实现类DataSource接口的类,不过能够将复杂的逻辑封装到统一的方法中
mybatis
- mybatis是一个持久层的框架,用于简化JDBC的操作
web开发三层架构:控制层(controller), 服务层(server),持久层(dao)
- 控制层:负责接收用户请求,根据请求内容调度服务层
- 服务层:程序的核心业务逻辑
- 持久层:负责与数据库进行交互(原生JDBC也是在此操作)
每层对上层而言提供功能接口。
JDBC存在的问题:
- 将数据库连接的代码和操作数据的代码写到一起,但理应分开:
不应该将数据库连接信息写死在java代码中——硬编码
因为对于经常变动连接关系的业务而言,每次变动数据库,就要对程序重新编译,打包,执行
- 对结果的解析很繁琐,很臃肿(resultSet)
- 频繁地连接与释放连接造成资源浪费,性能降低
myBatis解决:
- 配置文件application.properties
- 结果行自动封装成对象,各行又组织成集合
- 用连接池技术解决频繁地连接
mybatis与连接池:
mybatis支持三种内置的数据源类型
Pooled:采用池的思想的数据源
UnPooled:没有采用池的思想的数据源
JDNI:采用服务器提供的JDNI技术实现
(Java Naming and Directory Interface,Java命名和目录接口)
步骤
准备工作(在springBoot工程中使用):创建SpringBoot工程,准备好数据库表,对表的内容在Java中设置好实体类对象(每个属性是一个字段)
引入MySQL依赖,配置mybatis。
引入依赖:mybatis的包和MySQL的jar包(创建工程时选入)
因为mybatis替代了JDBC,所以JDBC需要的基本信息mybatis都要完成:
驱动+地址url和端口+用户名+密码
通过写到mybatis的配置文件:application.properties中完成配置。(在IDE中会显示的)

编写sql语句:写的是接口:相当于是对服务层调用而言,要实现的接口。

那么是谁实现的呢?mybatis底层来实现的这个接口
此接口,就是彼接口
maven项目需要手写pom.xml,但是在springBoot中设计了UI可以选哎
编写测试用例:
在test包下试图调用上面的接口——测试是在Controller层
- 问题1:由于是接口无法实例化对象
- 问题2:需要解耦,不能创建对象
在IOC容器中找需要的接口实现类
1
2
3
4
5
6
7
8
9
10
11
12@SpringBootTest
class DemoForMyBatisApplicationTests {
@Autowired
private UserMapper userMapper;
@Test
public void testListStudent(){
List<User> list = userMapper.list();
list.stream().forEach(user -> {
System.out.println(user.toString());
});
}
}
IDEA操作数据库的逻辑:
idea内通过编写测试用例,调用mapper接口方法,来调用mybatis底层的实现类进行操作
IDEA会扫描要操作的数据库
IDEA内导入数据库后,可以动态提示表名,表结构,主键…
打包成jar包的文件就可以在命令行启动了
java -jar + jar’s name
预编译:
指在编译java中的mapper接口时,将语句和参数分开准备。
由于语句有可能有许多类似或一致的,每条sql都加载新的语句或许不如找找匹配自身的语句。
加载新的语句包括:

预编译的过程就是将这类语句模板化/参数化,执行完以上流程。
???
优势:
性能更高:sql查询时的缓存机制是:对一条语句进行解析,优化,编译,再配合参数一起执行,于是就可以把同样类型不同参数的语句缓存起来——形式就是预编译。
原来sql语句优化并不都需要参数,某些根据语法就可以选择路径,但像limit需要知道参数…
更加安全:可以防止sql注入
示例:
1
SELECT `name` FROM student WHERE name="卡沙" and home='' or '1'='1'
例中or和and并排最后执行,但1=1必然成立,于是无论前面对不对,判断都能过
问题在于:查询语句和参数最后都拼接到一起,再进行查询优化,没有明确的区分
但在预编译下:
1 | |
参数传入之前的语句就已经进行解析、优化、编译了,事后再将占位符替换回参数就不会发生注入问题。

预编译的问号产生的一个问题:
在进行模糊匹配like时,因为一旦把占位符?传入模式串’’中,?的意义就会被覆盖。
解决方法有:
用${}代替#{}。
用concat()拼接%,?,%,因为cancat在?被替换成实际参数时才执行,所以可行。
mybatis中数据库表字段名与类属性名不一致的问题:
在select时我们试图用一个user对象自动接收一行的信息,使每个属性分别对应一个字段。
但mybatis只可能处理名字一致的属性,名字不同的则不会赋给此返回对象。
格外注意:Java的习惯是驼峰命名,sql的习惯的下划线命名,于是多个单词的属性往往不对应。
不合理,IDEA必有快捷方式
解决方法:
给字段起别名:
1
2@Select(select id,username,password,name,gender,dept_id deptId,create_time createTime from Emp where id = '1')
public Emp getById();通过@Results和@Result注解,手动映射封装
1
2
3
4@Result({
@Result(column = "dept_id" property = "deptId"),
@Result(column = "create_time" property = "createTime")
})在application.properties中配置自动转化
1
mybatis.configuration.map-underscore-to-camel-case=true
用xml配置文件编写sql语句
逻辑:
Dao层的接口方法每个都配置注解,看起来有点臃肿,惯用想法是分离到别的文件里
给每个接口方法都配置一个具体的执行sql,调用方法时只要把参数传进去就好
而这些具体的sql,统一写到另一个xml文件中
实际上是将每个mapper文件都配置一个mapper.xml,以下注意点是确保映射mapper能找到配置mapper.
注意点:
xml映射文件的名称和mapper接口名称一致,并且虽然xml在resources下,mapper在java源代码下,但二者形散神居,任要在同一个目录下同包同名
xml映射文件的namespace属性和mapper接口全限定名一致
xml映射文件的sql语句的id和mapper接口中方法名一致,并声明确定的返回类型(一行的数据应该投影到什么类型)
1 | |
动态SQL
<if> :用于选择某段话是否要加入sql
<where>:用于替代where,作用是动态地决定‘and’是否保留
<set>:用于代替set,作用是决定”,“是否保留
<foreach> :用于生成数组对象
<sql> and <include>: 用于提炼公用sql语句
1
2
3<sql id="commonSelect">
select id,name,home,age,sex,hobby
</sql>1
2
3
4
5
6
7
8
9
10
11
12
13
14
15<select id="selectConditional" resultType="com.example.demoformybatis.pojo.User">
<include refid="commonSelect"></include>
from student
<where>
<if test="name != null">
name like concat('%', #{name}, '%')
</if>
<if test="age != null">
and age > #{age}
</if>
<if test="sex != null">
and sex = #{sex}
</if>
</where>
</select>
1 | |
test里面的属性,来自函数调用时传入的参数,和后面的查询语句里的字段并非相同
也就是说:mapper.xml文件里,在标签中的都是和上层挂钩的,在标签外的sql语句才是要传给下层的。
开发!
一般前端怎么发post:——打包成一个请求体
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17const url = 'https://example.com/api/endpoint';
const data = { username: 'john', password: 'pass123' };
fetch(url, {
method: 'POST',
headers: {
'Content-Type': 'application/json'
},
body: JSON.stringify(data)
})
.then(response => response.json())
.then(data => {
// 处理响应数据
})
.catch(error => {
// 处理错误
});1
2
3
4
5
6
7
8
9
10
11
12import axios from 'axios';
const url = 'https://example.com/api/endpoint';
const data = { username: 'john', password: 'pass123' };
axios.post(url, data)
.then(response => {
// 处理响应数据
})
.catch(error => {
// 处理错误
});
以上fetch和axios都是发送异步请求的函数/包,但区别在于,fetch是浏览器原生的,axios是另外的库。
RESTful开发规范——关于CRUD(约定,不是规定)

略有讲究:查和删只需要传一点点参数,所以用原生get,改和增要传好多,所以要用原生post在body里面传递
restful中路径资源一般写成复数
如何限制接口方法只能响应某种类型
1
@RequestMapping(value = '/webURL',method = RequestMethod.GET)
或者:(源码实现就是上面的方法,相当于小语法糖)
1 | |
后端如何接收JSON对象来着?
是用一个对应的实体类对象接收,并声明注释@RequestBody
因为JSON是写在Request中Body里面的(post请求),所以这么声明也有点道理在RESTful中,由于crud的url路径前面部分都是一致的,所以可以提取到类名处声明

前端分页的逻辑:
古早版本中,我在前端用了巨臃肿的逻辑,先是把数据库的信息在挂载时就访问到参数里(这样写和直接写到前端其实没有区别),然后许多个v-if判断某些数据是否需要展示。
这样的问题在于:
写死每页的个数了
所有逻辑和数据都加载到了前端,而实际上只需要一页的数据
对crud很不友好哎
新版本:
既然前端只需要得到一页的数据(就是当下展示的哪一页),前端传递给后端需要的位置,后端分页查询到确定的,定量的数据后返回前端并展示。

分析好前端需要后端传什么,后端又需要前端传什么
前端需要具体x页的y条数据,还需要总的记录数n
后端需要从多少开始查(x-1)*y,查多少y。
Controller层的接口方法怎么设置默认值?
java中本身就没有像py里设置默认值的方式,但可以从逻辑上简单实现
方法体内声明(很局限,没有人往方法里面传null的)
1
2
3
4public void test(int l1,int l2){
if(l1 == null) l1=0;
if(l2 == null) l2=0;
}方法重载(洋人思维就是地道)
1
2
3
4
5
6public void test(int l1){
test(l1,0)
}
public void test(int l1,int l2){
//code
}在springboot中,声明@RequestParam(defaultValue=’’0’’)
pageHelper:
功能:屏蔽分页查找的逻辑,只要输入起步位置(从第几页开始),pageSize,然后查找全部需要行,工具包就会自动分页。
1
2
3
4
5
6
7@Override
public List<yuangongsalary> getSalary(Integer currentPage, Integer pageSize) {
PageHelper.startPage(currentPage,pageSize);
List<yuangongsalary> data = mapper.getsalary();
Page<yuangongsalary> page= (Page<yuangongsalary>) data;
return page.getResult();
}
文件上传:
客户端将本地的图片,视频,音频等文件上传到服务器,供其他用户浏览或下载
之前在Swing中的JFileChooser仅仅是打开文件和在本地操作,配合socket或许可以实现上传
前端文件上传三要素
输入框(文件选择器)
所在表单的请求方式为post
确定编码形式(大型二进制文件需要特殊编码)

mutipart/form-data:
如果用默认编码,前端发送的请求只会包含文件的名字
在此编码下,前端的请求会分为多个部分,按照表单的input框。所选文件的全部内容也会在post的body中被传递
后端接受
MultipartFile类接收
要点:
获取原始文件名等方法封装在MultipartFile中

如果据此来给保存文件命名的话,可能会重复冲突
如果根据当下时间来命名的话,也有可能因为两个客户端同时访问而从冲突
于是根据UUID保存文件
但保存文件仅有名字不够,还需要对应的文件后缀,这可以从原始文件名截取
于是拼接二者,构成文件名
通过MultipartFile中的transferTo()方法保存文件/或者自己写一个写入文件操作
问题:
- springBoot配置问题

如果一次请求有多个文件,可以按照数组/集合接收
文件保存到服务器并不地道,因为服务器主要是服务用的,保存的位置有两种选择
自己/企业搭建集群,用于存储文件|FastDFS,MinIO
使用云服务|阿里云,百度云,腾讯云,华为云…
阿里云OSS
云服务包括互联网行业各种服务,简单来说:通过互联网租用大厂已经铺好的路

OSS:对象存储服务(Object Storage Service)
云端基本思路:

SDK:Software Development Kit 软件开发工具包 其中包含软件开发的依赖(jar包),代码示例等待
OSS基本思路:

oss操作流程:
服务端将文件上传到OSS(客户端要先发给服务器,因为只有服务端有权限/密钥操作OSS)
通过OSS给Java的API进行操作,可以上传文件,字符串,流…
此处将上传方法集成出了工具类,用依赖注入方式使用工具方法
OSS针对每个文件会配置一个访问URL,客户端可据此访问到。
OSS云存储代码分析
通过OssClient客户端对象进行访问,创建时匹配参数(endpoint,accessId,assessKey)
ossClient来创建桶,存入项目,遍历桶,删除项目…
配置操作的参数——是通过发起Request直接调整后台,来使ossClient访问参数更改。
配置文件 application.propoties
目前的问题:
存在硬编码:既将某些和逻辑无关的参数写在负责逻辑处理的Java源代码中。
- 不易修改,也不易统一,也不易统一修改
配置方法:

K=V:key随意取,尽力和业务逻辑相关
引入方法:
@Value(“$(key)”) 声明在变量之上
用@ConfigurationProperties(prefix = “…”)注解自动注入
- 参数前缀是要注入的一批配置信息的公共前缀
- 下面声明的属性名需要和配置文件中的key一致
注意哦: 这样做其实又将原本配置在每个属性上的语句整体进行操作,但一个Java文件中可能不止引入一个大前缀下的配置信息,如果有多个大前缀下的信息要引入,可能引发冲突
于是地道的做法是:声明配置类:AliOSSProperties.java,其中声明一个大前缀的属性,给属性注入配置信息,并且设置get/set方法便于调用

yml配置文件/yaml
文件名:application.yml/application.yaml
配置内容格式:

各种配置方式对比:

yml语法:
大小写敏感
数值前面必须有空格,作为分隔符
使用缩进表示层级关系(据说不能用Tab,但IDEA会把Tab转化到定量空格)
注释符号是 # (WC!py!)
yml数据格式:
1 | |
登录与校验:
要为登录功能新开一个Controller,因为从访问路径考虑,不同功能要整合到同一大路径下,而登录功能与原本的职工Controller,部门Controller,上传文件Controller功能并无交集(对前端而言发送的请求路径大不相同)。
上传文件的Controller:Controller层的作用就是接收前端的信息,而对于前端发来的文件,后端需要传递给OSS,基本逻辑可以在控制层实现,但如果要对文件进行操作再上传,相比要进入service层了
会话:
会话:
用户打开浏览器,访问web服务器的资源,会话便建立了。直到有一方断开连接,会话结束。在一次会话中可以包含多次请求和响应。
会话是浏览器和后端服务器间的关系,浏览器访问一台服务器下多个方法/资源属于一次会话。
会话跟踪:
一种维护浏览器状态的方法,服务器要识别多次请求是否来自于同一个浏览器,以便在同一次会话的多次请求间共享数据。
技术落地
客户端会话跟踪技术:Cookie
服务端会话跟踪技术:Session
令牌技术
Cookie:(信息保存在客户端,请求顺带发送)
Cookie本身是http协议原生支持的方法,通过调用请求和响应内置API即可。
请求头中有Cookie:name=value,响应头中有Set-Cookie : name=value
服务器响应时传递set-Cookie,客户端发送内嵌此cookie的html
Cookie工作流程简述:
cookie本身是一个k-v形式的字符串,在浏览器和网站服务器之间交流
当浏览器登录GitHub:携带用户名,密码的请求发给GitHub后台
GitHub返回一个成功登录的响应,此响应内嵌一个身份认证信息——cookie。
cookie被浏览器记录在缓存中,并标记为来自GitHub的cookie
接下来浏览器对GitHub的访问携带cookie,后台通过cookie识别到身份后,进行逻辑上的区分

注意:
有些网站的cookie是分批次返回的,访问到网站不同区域返回不同的cookie,可能是网站要检测,伪装成cookie。
技术——利用cookie伪造身份
谷歌插件cookie editor导入/导出Cookie
记录黑客手段:避免在网站动态加载任何html格式 XSS攻击
类似SQL注入
假如v-html或者v-bind将一串html形式的字符串绑定到某标签,渲染此标签时,该字符串内的模拟标签也会被加载。
如果业务上存在用户输入——且某黑客用户按照html格式输入黑客网站+获取当前cookie的JS代码,即可能悄悄更改源码,诱导其他用户进入危险网站。
一般通过JS代码可以获取当前cookie,
document.cookie
但只要将cookie细则加上http only限制,仅限http访问使用,可以避免cookie失窃
Cookie in Java
发现原来SpringBoot的Controller也可以直接接收HttpServletRequest和HttpServletResponse对象,这个API又要解析,又要转型,还要映射,真狠了。
在给浏览器的响应中设置Cookie(感觉在过滤器中有大用)

在浏览器的请求中查看Cookie

优点:HTTP协议中支持的技术,许多解析,添加操作封装在协议中。
缺点:
移动端无法使用Cookie
不安全(因为数据存储在浏览器,是面向客户的),用户自己可以禁用Cookie(导致后端策略失效)
Cookie不能跨域
Session
流程:
浏览器第一次访问后台时,后台建立Session对象(有唯一的SessionId)
后台对浏览器的响应中,通过Cookie形式传递Session信息
然后浏览器保留SessionId,在接下来的访问中携带SessionId作为标识符
Session in Java
- 建立Session对象/设置Session对象

- 获取Session对象

可以直接接收HttpSession,也可以从HttpServletRequest中解析出HttpSession
优点:Session的信息存储在服务器端,一般用户访问不到
缺点:
如何后端服务器是用集群做的负载均衡,则后端存储的Session信息需要同步
只要信息存储在前端就不需要考虑集群的复制-----Jwt令牌单个服务器自然也不考虑由于底层是Cookie,所以Cookie的毛病它也有
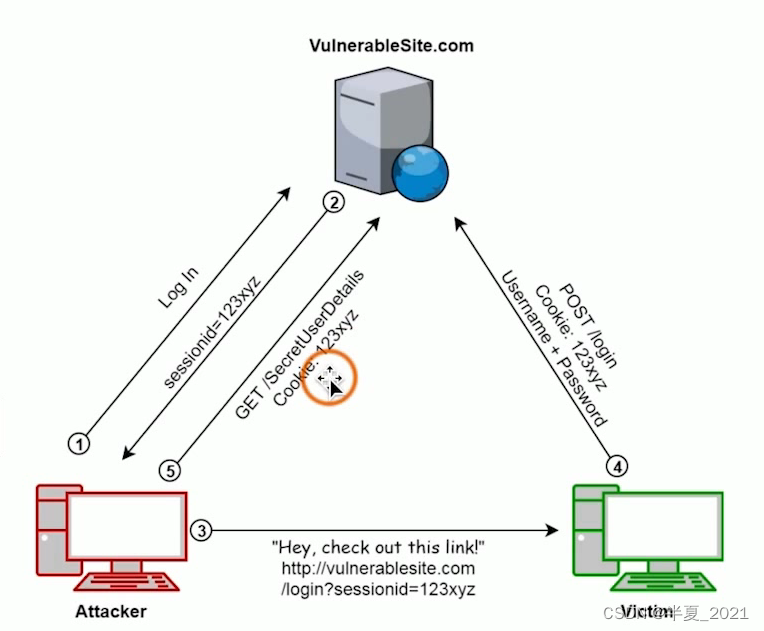
Session Fixation(Session固定–表示黑客用正常用户的Session访问)
令牌
流程:
整体流程还是类似
用户登录发给后端服务器信息,后端生成一个身份标识令牌,发回给客户端
客户端将其保存到本地,可以是存储在Cookie中,或localStorage或sessionStorage
客户端再发送请求时,将令牌添加到请求头或请求参数中
服务器接收到请求,解析令牌,验证有效性合法性
大致流程和Cookie类似,但并没有限制在Cookie中,似乎更加灵活
JWT
JSON Web Token
是一个由三部分组成的字符串
Header(头)记录令牌类型,签名算法等
例如:{“alg”:”HS256”,”type”:”jwt”}
Payload(有效数据),携带一些自定义信息,默认信息等
例如:{“id”:”1”,”username”:”Tom”}
Signature(签名),防止Token被篡改,确保安全。将header,payload
将Header和Payload通过Header中alg声明的算法加密。
结果:

过程:
前两部分的JSON通过Base64编码到字符串
Base64:
基于二进制的数据表示方法
将字符串先转化成二进制表示,再用包含64个符号的字符集来表示
64:a-z,A-Z,0-9,+,/
项目流程

但使用JWT需要通信双方提前共享密钥,才能实现数据的加密和不被篡改
不过通信中必然需要数据加密
Spring之间的关系
- Spring Framework是最基础的,最核心的Spring框架。
- SpringMVC是Spring Framework中关于web开发提出的解决方法,简化了原始servlet,身份类似JDBC Template
- Mybatis还是Mybatis
以上三者就是SSM
- SpringBoot整合了SSM,提炼出较为简单的逻辑。
跨域
理解版本一:
从一个域名发送请求到另一个域名,可能包括AJAX请求,图片请求,字体请求等
背景
浏览器如果要将html文件加载到用户的计算机上,就先要鉴别此文件有无潜在的安全风险。
防止跨站请求伪造(CSRF):
假如某网站用其用户的身份(留在浏览器缓存的cookie),以用户的名义请求别的网站(攻击者引导用户访问恶意网站),——禁止跨域——禁止外来有权限地址进行访问。
详细不明,略难
为了保护用户信息的安全
前提:各个网站对同一用户的cookie虽有不同,但内含信息一致,可以伪造;
假如没有同源政策,A,B网站都拥有用户WSL的cookie,则A可以用用户的身份访问B。
同源政策限制了网站只能加载自己的内容(来自同源的服务器上的内容)。
详细不明,略难
理解版本二:
跨域是浏览器对JavaScript的限制,禁止对非同源的资源进行请求
也就是说:不经过浏览器就不会有跨域问题——Java后台访问数据库、Nacos…
跨域资源共享(CORS)
是一种基于HTTP头的机制,允许服务器标识除了他自己以外的其他源(域、协议、端口),使得浏览器允许访问加载这些源的资源。
跨域流程:

有一系列简单请求,不需要提前发送预检请求
需要同时满足多个条件(也就是各个方面都很简单)
请求方法限制

仅有部分标头允许人为设置(请求头限制)

传输媒体类型限制

else

在此图中:禁止跨域即第二步服务器响应的信息中不包含CORS
解决方法
Nginx 代理

思路:
既然浏览器对服务器的直接访问不成,就加个中介代理,经过代理获取服务器资源。
修改第二步的响应头,添加CORS,允许跨域
思路:
在网关中配置Filter,目的是为了为每个响应头添加允许跨域的信息
具体操作:
在网关微服务中创建一个配置类对象CrosWebFilter,据说只要将此对象加入容器中,即可完成添加配置信息
同源政策:协议+域名+端口三者相同
既然是浏览器的政策,那么在不涉及浏览器时的前后端交互中并不影响
据说有三个标签是允许跨域的:
<img>,<link>,<script>里面的src和href
常见跨域场景
当协议,子域名,主域名,端口号中任意一个不同时,都算不同域
Attention:
域名和域名对应的ip也不行
- 跨域时,请求能发出去,服务端能收到请求,并能正常返回结果,只是结果被浏览器拦截了
过滤器
Servlet Filter接口,用于在Servlet容器中对http请求和响应进行拦截和处理。
用于访问控制,安全验证,日志记录,字符编码转化等功能
Filter接口定义的三个方法
init方法——Filter被初始化时调用,用于进行一些初始化操作
doFilter方法——对http请求和响应进行拦截和处理的核心方法,对请求进行修改或过滤,对响应进行修改或增强
参数:request,response,chain
destory方法——Filter被销毁时调用,进行一些清理操作
Filter接口的实现类常常在web.xml文件中进行配置,指定要拦截的URL模式,以及要使用的过滤器。
//也可以用注解形式
@webFilter()
常用属性
filterName:过滤器名称:用于在web.xml文件或其他注解中引用
value/urlPatterns:过滤的URL模式,是一个字符串or字符串数组
despatcherTypes:指定过滤器处理的请求类型,如REQUEST,FORWARD.INCLUDE,ASYNC.
initParams:过滤器的初始化参数
asyncSupported:指定该过滤器是否支持异步请求
流程:

客户端请求访问容器中的web资源
Servlet容器接收请求,针对本次请求,创建一个request和response对象
请求在到达web资源之前,先调用Filter的doFilter()方法,检查其中对request对象的操作(修改请求头和请求正文等预处理)
在Filter的doFilter()方法内,调用FilterChain.doFilter()方法,将请求传递给下一个过滤器或者目标资源。
目标资源(servlet)生成相应,返回到客户端之前,还会再执行Filter的doFilter()方法,检查对response对象的修改(修改响应头和响应正文)
响应信息返回客户端
生命周期:
- Filter实例在Servlet容器启动时创建,由Servlet容器负责创建和管理。
过滤器链传递

mapping到同一访问路径的过滤器们的顺序和在web.xml中配置的顺序相关。
在基于注解的配置中:
竟然是根据类名的字典序?????不如配置文件一根毛
过滤器的路径配置
<url-pattern>
完全路径匹配:以/开始,比如/aaa,/register.html
目录匹配:以/开始,以*结束,比如/*,/aaa/*
扩展名匹配:以*开始,扩展名结尾,比如*.jsp,*.html
<servlet-name>
- 按照servlet的名称进行对servlet的拦截
<dispatcher>
用来描述过滤器对不同类型的请求是否过滤
REQUEST:默认拦截请求
FORWARD:过滤转发
转发:据说是在服务器内部将请求从一个servlet传递给另一个servlet的机制
INCLUDE:过滤包含
包含:据说是当一个servlet包含另一个servlet的响应内容时的机制
ERROR:表示过滤器将在请求处理过程中发生错误时进行过滤,即请求由于某种原因而无法正常处理,比如抛出了异常。
ASYNC:表示过滤器将在异步Servlet请求调度时进行过滤。
异步:一种在Servlet容器中启动的,可以在后台异步处理的请求。
过滤器+令牌实现身份验证

对所有请求都要附加token,后台的拦截器会拦截所有请求,根据token选择是否放行
还有实现方式:
网关 | 网关更关注将请求路由到各个微服务,不过也能配置网关的Filter
Spring Boot原理初识
配置优先级

表示当同一个配置在多个文件中有不同内容时,优先选择哪个
开发中一般用统一的格式配置
除非~~~优先级高的定义Nacos的位置,优先级较低的定义需要Nacos配置文件中信息的配置。
以项目运行环境配置
- Spring Boot支持Java系统属性和命令行参数的方式进行配置

系统属性更核心的功能是改变JVM内存配置
Spring boot项目运行逻辑
IDEA中调用SpringApplication.run()时并不会执行完整的项目运行逻辑,而是直接运行SpringBoot程序
企业生产环境中,会将应用程序打包成jar包,并在生产服务器上进行部署和运行
过程:
Maven或者Gradle对项目进行打包(Package),之后便可在target文件夹下找到jar包
运行jar包
JVM启动
在jar的清单文件(META-INF/MANIFEST.MF)中,找到指定的主类(调用SpringApplication.run())
初始化主类和Spring Boot运行环境
自动配置和依赖注入
启动Tomcat等嵌入式web服务器
监听端口
Spring boot 中bean的管理
获取Bean
由于Spring项目启动时,会把bean都创建好放在IOC容器中,可以主动获取这边bean
主动获取bean和被动注入bean是两种获取容器中对象的方式
方法:
获取容器对象

由容器找寻bean

Bean的作用域
Spring支持五种作用域


当作用域为singleton单例:每次调用bean都会获取容器中唯一的一个对象
当作用域为prototype非单例,每次调用bean都会创建一个新的bean对象
关于@Lazy
是将bean的创建延迟到第一次使用bean对象(而非项目启动时)
第三方bean对象
在导入的jar包中,有时需要创建其中某个对象,但又要避免显式的new,这个jar包又不会自动的创建bean对象,就需要手动将其中对象加入到IOC容器中
做法:
在项目启动类中声明要注入的对象,于是便在同一时期将此对象和其他bean对象一同加入到IOC中

但在开发中一般不会在启动类写太多东西,而是将此写在配置类中

bean对象的名字是方法名
bean对象创建是如果需要其他bean作为参数,直接写,SpringBoot完成依赖注入
配置类:
在Spring Boot启动阶段运行(和写在启动类中效果一致)
常见配置:

Spring Boot 原理
早期开发是基于Spring Framework核心框架,难点在于需要进行繁琐的依赖管理和配置管理(包括bean),而在Spring4之后出现了简化SpringFramework开发的————Spring Boot。
Spring Boot提供了两个关键功能来简化SF——起步依赖 + 自动配置
起步依赖
通过引入一个spring-boot-starter-web来引入web开发需要的基础依赖,通过maven的依赖传递实现
主要实现也就是把核心几个依赖预定义(管理)了,感觉没什么技术含量

自动配置
SpringBoot在Spring容器启动后,自动将一些配置类、bean对象加载到IOC容器中,不需要手动声明

IOC中有一些基础功能类的bean对象,可以在程序中直接Autowired
自动配原理
依赖的包怎么创建成bean对象?
扩展包扫描
原本启动类会对其所在包和子包进行包扫描,并将声明了bean类注解的类创建为bean对象,于是只要让启动类也扫描一遍依赖包即可
启动类的扫描范围确实不大,即使它能够更大,但是却选择不大
解决方法:

@Import导入
使用@Import导入的类会被Spring加载到IOC容器中。
由于包扫描存在几点问题:
由上操作下(确定包扫描范围)耦合度较高,需要控制反转
全包扫描性能损耗略大,整个包未必有几个bean对象
使用@Import只能明确导入哪几个类,似乎也没解决第一个问题
导入形式:
导入普通类

导入配置类
配置类中声明的bean对象即完成注入IOC

导入ImportSelector接口的实现类
通过某些逻辑得到要创建bean对象的类名

使用@EnableXXX注解,注解中封装有@Import注解
由于由上层确定下层要导入那些类太繁琐,于是将导入的选择交给下层完成
下层创建注解@EnableXXX,封装有@Import注解,明确在自己的包内哪些需要被Import。上层只需要对整个包声明@EnableXXX即可完成导入需要的类
源码分析:
- 启动类进入关键配置@SpringBootApplication

分析此注解的几个注解

@Target,@Retention,@Documented,@Inherited是元注解
@SpringBootConfiguration 中封装有@Configration,表示此类是个配置类,可以声明@bean对象
@CompoentScan中明确包扫描范围
@EnableAutoConfigration 表示与自动配置相关
进入@EAC

关注@Import,通过此@Import导入的类,可以一直向上传递到启动类(也是配置类),于是就可以加入IOC
进入AutoConfigrationImportSelector
是ImportSelector的子孙类
核心方法:


概述:
从两个文件(SpringBoot3中仅有一个)中加载某些东西,最后selectImports()中作为字符串返回,表示需要加载这些类
文件:
META-INF/spring/org.springframework.boot.autoconfigure.AutoConfiguration.imports

装有每个导入依赖的XXXAutoConfigration类的全类型
随便进入一个

发现XXXAutoConfigration全是配置类,需要对外暴露的bean对象全部在此声明。
且需要注意:@ConditionalXXX表示此类在某些条件下加载bean,某些条件下不加载bean
问题:
此文件中并不包含导入的依赖,而全是org.springframework的类,表示此文件只是在项目启动前就存在的基础配置文件。
关于导入的依赖是如何成为bean的,暂不明
自定义starter
是将较为公共的代码封装起来,形成对上方便可用的依赖,项目中一般会将此起名为starter
spring-boot-starter-web,mybatis-spring-boot-starter,pagehelper-spring-boot-starter...
命名规范:
SpringBoot官方提供:按照spring-boot-starter-XXX
其他组织提供:按照XXX-spring-boot-starter
举例说明starter基本模式
mybatis

此依赖的jar包中没有源代码,只有pom文件,表示此依赖类似聚合项目,仅是将各种可能的依赖包裹起来
pom中关键依赖: 是关于将此jar包的bean对象自动配置进IOC的
起名就叫autoconfigure,表示此依赖是整个starter的bean的自动配置

在此jar中存在META-INF/spring/org.springframework.boot.autoconfigure.AutoConfigration.Imports文件
各个依赖里竟然都叫这个

文件里定义了配置类的全路径
具体实现说明
封装阿里云OSS
外层聚合项目,内层核心autoConfigure项目
autoconfigure:
在此项目中完成对象+逻辑的使用,并且对象通过配置类暴露到IOC中
由于此项目需要通过固定格式的配置文件将对象暴露,并且上层Spring也扫描不到项目的bean,于是项目整体结构就不按照容器化进行
但也没有像原生Java一样随便new,而是在配置文件中声明bean时,通过set方法手动注入依赖对象。

Spring Security
核心功能:
认证:验证某个用户能否访问系统 | 根据用户名密码来完成认证功能
授权:验证某个用户是否有权限执行某个操作 | 系统中角色权限分层
保护思想:
- 通过添加一系列过滤器/拦截器进行保护,对请求进行过滤
封装逻辑:
如果是基于Session,那么Spring security会对cookie里的sessionId进行解析,找到服务器中存储的session信息,加以判断当前用户是否符合要求
如果是基于token,则会解析出token,然后将当前请求加入到Spring security管理的权限信息中去
认证与授权的思路:
如果系统的模块众多,每个模块都需要进行授权与认证,所以选择基于token的形式进行授权与认证。用户根据用户名和密码认证成功,然后获取当前用户角色的一系列权限值,并以用户名为key,权限列表为value下形式存储在redis缓存中,根据用户名相关信息生成token返回,浏览器将token记录到cookie中去,每次调用api接口都默认将token携带到header中,Spring security解析header头获取token信息,解析token获取当前用户名,根据用户名就可以从redis中获取权限列表,这样Spirng security就能判断当前请求有无权限访问了
spring的starter设计思想:
导入依赖包后,由于有自动配置文件,默认AOP下添加了许多功能
认证流程:

网络安全:
CSRF 跨站请求伪造 攻击
指构建恶意页面,引导用户访问对应网站执行操作的方式:
例如:
同一个浏览器中,用户刚刚登录了银行,在浏览器中保存了cookie或者sessionId或者token,恶意网站表面的一个按钮/输入框其实通向银行后台,当点击按钮/提交表单时,对外界而言和在银行网站进行并无区别当代浏览器的解决措施:
- 当访问不同站点(目的服务器)时,自动屏蔽别的cookie | sameSite
SFA 会话固定 攻击
指黑客将自己的JSessionId给用户让用户登录,后来黑客就可以用此JSessionId直接进入登录状态
常用场景:
黑客将恶意页面中填充一段JS脚本,用来设置Cookie中的SessionId为自己的解决措施:
让浏览器对Session设置为禁止修改(HttpOnly)

httpOnly表示只能通过http协议读/写到,从而屏蔽js脚本
XSS 跨站脚本 攻击
攻击者在合法网站中注入恶意脚本代码来攻击用户
常见类型:
脚本注入:在实现发帖行为时,帖子可能用户怎么写就在DOM中怎么展示,一旦用户写一些掺杂JS脚本的HTML语法,<p onload="alert('yes!')"></p>,就会导致界面上允许运行恶意代码